2019年年鉴

这一年不知不觉又过去了,一年很长,但是到了年底,能回忆起来的事情不多。今年没有什么大事发生,还是一如既往的工作,生活。这篇文章,就来回忆一下今年的屈指可数的收获吧。本质上我写这篇文章是出于习惯,所以你阅读本文基本上不会有什么收获,建议不要浪费这个时间。:)

要说进步,今年值得表扬自己的是,一些存了很久的疑问,今年逐渐一个一个给了自己满意的回答,比如 Linux 分区是什么工作的,文件系统是什么工作的,什么是 Daemon 进程等等(写了这么多 Linux 的文章,感觉这个博客需要开一个 Linux 分类了)。以及一些由于不明白而困扰自己的很幼稚的问题。这些答案基本上都来自 Linux System Programming 这本书,细说起来这本书是从 5 月份就开始读的,快到年底了才读完。如果你和我一样对于 Linux 有很多懵懂的问题的话,也推荐你读一下这本书。上一次给我这么大启发的书,还是 Fluent Python 了。作者(Family Name 竟然就叫 Love)具有丰富的 Kernel 开发经验,解释问题比较深入浅出。缺点就是书中解释各种 Error 含义的篇幅有点过多了,都是手册里面的内容,感觉有凑字数之嫌。

除了 Linux,今年还看了一下 Scheme(The Little Scheme)和 Elixir (The little Elixir & OTP Guidebook-Manning)这两本书,都是入门级别的。这两门语言和 Python 有很大的不同,比如 Elixir 有模式匹配,函数内可以写 when 来检查参数,Atom 的类型等等,也给我一些启发。

工作

今年上半年还是一种很不好的工作状态,每天的工作中,和同事沟通占用了大部分的时间,SRE 像是一个技术支持的工作,不断的协调,和不同的部分解释沟通等等。手里同时会被分好几件事,分身乏术。客观上说,总是感觉自己的工作没有意义,学到的东西也不多。

下半年组织结构调整,被调到了另一个组,做一个定位系统故障的系统。简单来说,就是业务不正常了,我们开发的这个系统要能自动定位到是一台机器的问题,还是一个机房的问题,还是数据库的问题,给应急提供一些辅助信息。项目语言是 Java 写的。因为我在之前的组中也尝试过这种定位系统,没有特别明显的结果,之前公司中失败的案例也不少,所以一开始对这个项目是没有信心的。但是做了半年,逐渐有效果了,有一些思路可以自己实现,觉得还是能取到一些成果了。

说来可笑,这几乎是入职以来,第一次能够专心写代码的时候。虽然到底要怎么做还不是很清晰,很多地方要自己摸索,但是工作状态相比之前是好了很多。

另外我们组是用 Java 来开发的,这门语言挑战了我的认知。我写 Python 的时候,每一行代码我都知道是做什么的,现在写的 Java,有很多代码看起来匪夷所思。比如 NPE,像 Python,JavaScript,如果你从 None/Undefined 试图获得一个属性,这些语言都会提示你 xxx 并没有这个属性。Java 呢?NPE。foo.getA().getB().getC(),NPE;call(foo.getA(), bar.getB()) 每当看到 NPE 这个错误的时候都让人痛苦万分,我要为这个简单的错误花很长的时间复现、排查。类似的例子还有很多。

总体上说,我觉得用 Java 开发项目的这段时间,我并没有因为这门语言学到什么启发性的东西(不像Elixir,Scheme)。在我看来,很多 Java 里面才有的东西是纯粹为了 Java 语言本身的问题,放到其他语言上很可能不需要这么做。我这么想也可能是我对这门语言学习的不深,使用的时间不长。以后这个想法也可能改变。

开源和社区

捕蛇者说。这是今年做的一件事,由 laike9m 发起的。Adam,Manjusaka 我们几个人一拍即合,就开始搞了。搞起来网站,在 V2EX Twitter 发了几个帖子宣传,然后开始录制,剪辑。现在看来这件事情是比较可持续发展的,除了剪辑的工作外,不会太让人疲惫,应该不会像 HZPUG 那样一直鸽掉了。今年一共录制了 10 期,感觉还会有源源不断的话题,接下来一年的发展我比较有信心。这件事情对我来说,最大的收获是结交的朋友了,要说学到什么,可能没有读书那样性价比更高。大家交流更多的是一些软性的东西,可以让你知道这么做一件事对不对,一条路是不是对的,类似这样。

PyCon。今年在 PyCon 做了两次演讲,个人觉得,内容比较浅薄。但是后来经常有人跟我说 Migration 那个演讲很好,还有人跟我讨论他们公司的 Migration 的一些方案,很高兴。

开源项目。业余时间,今年主要在做两件事情。第一个是 clock.sh(尚存在一些问题,个人认为还没有到稳定阶段,但是大家可以试用) 。这个项目就是想托管一些个人的定时脚本,没有很大的野心,做一个个人的 Saas,小而美,就够了。至于这个项目的最开始的动力,其实是我之前写爬虫的时候,我们有一个项目叫 xxx-control,里面有一个很长的 crontab 文件,用来管理爬虫什么时候启动执行,那时候我就想有一个更友好的定时任务控制的平台。这个项目我一直按照我的想法去做,半年之前有一个可用的 demo 版本,能通过在网页上简单的点击记下,就设定好一个定时任务了。后面有些慢 SQL 的问题,以及支持自定义 Docker 镜像的问题,一直没有时间解决。

第二个项目是 IRedis,这个是由于第一个项目用 Redis 作为 broker,而我又不太熟悉 Redis 那么多命令。所以就像要一个像 mycli/pgcli 那样的命令行工具。于是就自己开始写了一些。陆陆续续地,IRedis 支持的命令也越来越多,希望能在这个项目1周年的时候发布 1.0 版本。

我的第二个项目是为了解决第一个项目的问题而诞生的,此外还因为用到一些第三方库有问题,去给他们提交了一些 Pull Request。其实今年还有很多很好玩的想法, 精力有限,只能放弃那一些了,先把已经开始的项目做好。

工作上比较忙,正常晚上到家就10点了,所以自己的想法一直苦于没有时间去实现。现在的工作方式比较不健康,我还是想有一个正常的作息时间。

其实这么长的工作时间对公司来说,也未必是一件好事。依我个人看,会减少我对工作的热情,阻碍员工的发展。一周工作 40 个小时的时候,我还是盼望着上班的。太长的工作时间,客观上看,大部分时间也都被没有意义的事情给浪费了。另外很多公司不明白的一件事情是,如果给员工提供的是这样一种环境,那么大部分人的想法将会是不会在这一家公司工作很久,等自己能力提高立马换一家工作和生活更平衡的公司。如果没有时间学习(个人认为真正能学到新的技能的工作岗位很少),那么员工的价值也不会提高。为什么这些公司可以花很多钱从外面招厉害的人,而不愿意培养自己的员工成为那样的人呢?

如果我将来开一家公司,我一定不会认为工作时间长的员工是好员工。相反,我会看他们是否对技术有热情,是否有对自己不了解的事情有求知的渴望,无论这些事情是古老的技术还是新潮的技术。对于刚毕业的学生,一定要想办法减少他们花在没有意义的工作上的时间,一定要有至少20%的工作上的时间自由支配用于学习,一定不要给他们灌输:程序员必须学管理,程序员的“软技能”很重要,以及鸡汤。健康、可持续的生活和工作方式,比焦虑,没有意义的努力和长时间的工作要好一些。

未来的打算

  • 今年一年看的好代码太少了,需要学习一下 debug 工具链,多阅读好的代码;
  • 掌握 Elixir,我觉得这门语言很不一样,尤其是自带 supervisor,9 个 9 的可用率,比较吸引我;
  • 了解更多有关分布式系统,数据库的内容;
  • 锻炼身体,改善生活方式;


往年:

  1. 2013年
  2. 2014年
  3. 2015年
  4. 2016年
  5. 2017年
  6. 2018年
 

Daemon Process

本文介绍一个从 Linux 的 shell 诞生的进程,要经历怎样的“考验”,才能成为一个 daemon 进程。

后台进程,顾明思议,在后台执行,没有终端,没有 Login shell。当某些 Event 发生的时候进行处理,或者定期执行某项任务。通常,daemon 进程以 d 结尾,但不是必须的,比如 Redis 和 Nginx 的 daemon 进程就没有以 d 结尾。

后台进程最明显的特征,是 shell (通过 ssh 或者 terminal app 打开的终端)退出之后,后台进程不会退出,而是继续运行,提供服务。

简单来说,daemon 需要具备以下两项基本条件:

  1. 是 init 进程的子进程;
  2. 没有连接到任何 terminal;

此外,daemon 进程通常还会做以下几个事情:

  • 关闭所有的 file descriptors,除了 input, output, error 这三个。因为这些 file descriptors 可能是 shell,或者其他进程。而后台进程最关键的就是不连接 shell 和 terminal。可以使用 open_max 或 getrlimit syscall 获取当前打开的最大的文件描述符,依次关闭。也可以遍历 /proc/self/fd 下的文件,依次关闭。
  • 将 working directory 切换到 / 目录。daemon 的生命周期一般伴随整个操作系统的工作时间,如果一直在继承自父进程的 working directory 工作的话,就会影响操作系统运行期间的文件系统 mount 操作。某些进程也可以切换到自己的特定目录工作;
  • 将 umask 置为默认值,通常为 0。因为 daemon 进程创建文件的时候,会想自己设置文件的权限,而不受 umask 的干扰。如果使用的第三方库的话,daemon 可以自己设置 umask 的值,自己限制使用的第三方库的权限;
  • 离开父进程的 process group,这样就不会收到 SIGHUP 信号;
  • 离开 controling terminal,并确保以后也不会再被重新分配到;
  • 处理 SIGCLD 信号;
  • 将 stdin stdout stderror 重定向到 /dev/null。因为后台运行的进程不需要用户输入,也没有标准输出。这样也可以确保当其他用户 login shell 的时候,不会看到 daemon 的输出。

这是 daemon 进程通常会做的事情,man 7 daemon 中有更详细的描述。 接下来,主要讨论 daemon 最精彩的部分,即如何通过两次 fork() 来完成脱离 terminal。

两次 fork()

前面介绍了一些比较简单的处理,比如 chdir,reset umask。接下来讨论如何脱离 terminal。

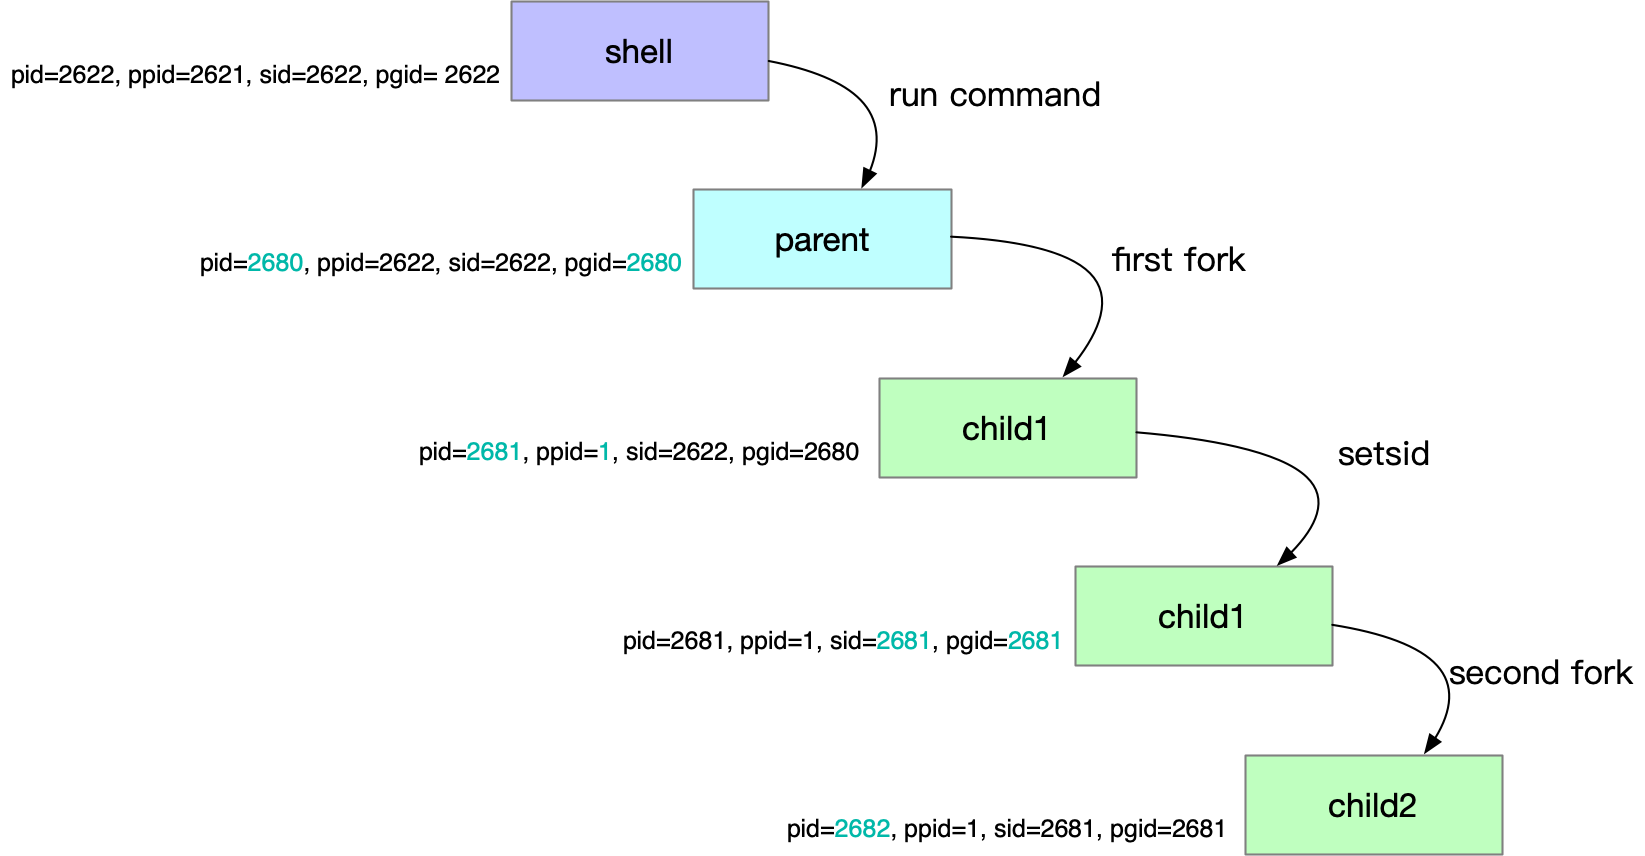
为了方便读者理解,我先画一张图,并标出每一步动作发生了哪些变化,然后再具体解释。

Shell 创建进程的过程如上图。这里先解释一下 4 个概念:

  1. pid 是什么?进程 ID,一个进程最基本的标志。创建新的进程的时候 kernel 会分配一个 pid。
  2. ppid 是什么?创建此进程的进程,即父进程,这里就是 shell 的 pid,因为进程是从 shell 创建的。
  3. sid 是什么?sid 指的是 session id,本文不作过多介绍,读者可以认为是和 shell 在一组 session 的进程,这样 shell 退出的时候会给 session leader id 为 shell id 的进程都发送 SIGHUP,将自己产生的子进程都一并退出,方便管理。所以,新创建进程的 sid 也是 shell pid,自动加入 shell 的 session。
  4. pgid 是什么?pgid 是 process group id,是一组进程id。考虑这种命令:grep GET accessl.log | awk '{print $1}' | sort | uniq ,如果我们想结束这个命令的时候,不会想 grep,awk.. 这样一个一个的结束,而是想将他们一次性全部结束。为了方便管理,shell 会将这种管道连接的进程置为一组,这样可以通过 pgid 一并结束,方便管理。所以,新创建的进程的 pgid 是自己,它自己也叫做 group leader。

第一次 fork()。 调用 fork(),父进程立即退出(为了方便后续讨论,我们将这次的子进程称为 child1)。这里的作用有3个:首先,进程是从 shell 启动的,如果进程不结束,那么 shell 的命令行将 block 在这里,这一次 fork() 让 shell 认为父进程已经正常结束了。其次,child1 fork 出来的时候,默认加入了父进程的 progress group,这让 child1 不再是一个 group leader(它的 pgid 不等于 pid),这是调用 setsid 的必备条件。实际上,由于父进程退出,child1 所在的 process group 已经是一个 Orphaned Process Group。第三,由于父进程已经退出,所以 child1 的父进程是 init 进程。

setsid。由于 child 的 sid 依然是 shell 的 id,所以当 shell 退出的时候依然会被带走。所以这里要调用 setsid ,脱离 shell 所在的 session。但是 setsid 之后,它的 pgid 和 sid 都等于它的 pid 了,这意味着它成为了 session leader 和 group leader。这其实就是为什么要 fork 第二次的原因,也是我最大的困惑,和花了最多时间去理解的地方。

第二次 fork() 。为什么要第二次 fork() ?这个问题我读了很多不正确的 Stack Overflow 讨论,以及没有第二次 fork() 的实现,比如 Linux System Programming 5.7 Daemons 中的 daemon 代码就是没有第二次 fork() 的,Kernel 提供的 man 3 daemon 也没有第二次 fork。需要做第二次 fork() 的原因很简单:如果一个进程是 session leader,那么它依然有机会获得 tty 的(在基于 SysV 的系统下),我们要确保它不可能获得 tty,就再 fork() 一次,并且退出 child1,确保最终提供 daemon 服务的 child2 不是一个 session leader。

这个过程也可以看下  daemonize 里面的 daemon 函数,和上述过程一样。

我写了一段代码演示两次 fork() 各种 pid 的变化,得到的结果会和上图一样。

#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>
#include <stdlib.h>

void printid() {
    pid_t pid = getpid();
    pid_t ppid = getppid();
    pid_t sid = getsid(pid);
    pid_t pgid = getpgid(pid);
    printf("pid=%d, ppid=%d, sid=%d, pgid=%d\n", pid, ppid, sid, pgid);
}

int main(){
    printf("parent process: ");
    printid();

    if ((fork()) != 0)
        exit(0);
    printf("child1: ");
    printid();

    setsid();
    printf("after setsid: ");
    printid();

    if ((fork()) != 0)
        exit(0);
    printf("child2: ");
    printid();
    return 0;
}

运行结果如下:

$ gcc fortest.c
$ ./a.out
parent process: pid=2680, ppid=2622, sid=2622, pgid=2680
child1: pid=2681, ppid=1, sid=2622, pgid=2680
after setsid: pid=2681, ppid=1, sid=2681, pgid=2681
child2: pid=2682, ppid=1, sid=2681, pgid=2681

Protocol Mismatch

如果使用 systemd 这种任务控制机制的话,注意需要按照这些系统规定的 readiness protocol 来设定你的程序,即你要可以将 chdir,umask 这种事情托付给 systemd 来做,但是你要遵守 systemd 的协议来告诉它你的进程就绪,可以提供服务了。

常见的一种错误是在自己的进程中 fork() 了两次,但是在 systemd 中使用了 Type=simple ,并认为这样是告诉 systemd 自己的进程是一个普通进程,自己处理了 daemon。而实际上,这是在告诉 systemd 你的进程是启动后立马 ready,ExecStart 的进程就是目标进程,所以在第一次父进程 fork() 并退出的时候,systemd 认为你的进程挂了。 很多时候,比如用 systemd 控制 Redis Nginx 这种服务,总是启动超时,一般也是因为这个问题。 这里有很多常见错误的例子,就不一一解释了,介绍 systemd 的使用,又要写一篇文章了。

感谢依云和@mrluanma解答我百思不得其解的一些困惑。

参考资料

  1. What is the reason for performing a double fork when creating a daemon?
  2. What are “session leaders” in `ps`?
  3. Daemonize a process in shell?
  4. daemonize — A tool to run a command as a daemon 非常值得一读,代码只有几十行,对理解 daemonize 很有帮助。
  5. Linux System Programming P172
  6. Orphaned Process Groups
    1. APUE 9.10. Orphaned Process Groups
    2. GNU 28.4 Orphaned Process Groups
  7. TUE Linux Kernel
  8. Can systemd handle double-fork daemons?
  9. man 7 daemon 介绍了新式的 systemd daemon,和之前的 SysV 有什么不同。systemd 不会进行第二次 fork() ,所以你会发现用 systemd 管理的服务都是 session leader。这是因为这些服务不是从 shell 启动的,而是 systemd 启动的。
  10. daemon-skeleton-linux-c 另一个比较简单的 daemon 代码,可以直接编译运行
  11. Linux-UNIX-Programmierung – German
  12. Unix Daemon Server Programming
 

程序员如何高效和同行交流

你是否在工作中经常遇到这种对话:

A:你给我的接口为啥访问不通啊?

B:确定是 POST 方法吗?参数 foo 加了吗?

A:加了啊?

B:我看下。

5分钟后。

B:你没加 application/json 啊。

A:还是访问不通啊。

B:我看下。

5分钟后。

B:URL 后面不能加 / 啊,不需要加。

A:……

B:……

本文介绍一些如何避免这种无意义的对话的方法。个人认为,写在简历里面的“沟通能力强”并不是一个软技能,而是一个硬技能。不是说话啰嗦,敬词用的多就是沟通能力强,而是用最少的话把信息描述清楚没有歧义,这要求理智和健全的身心,以及相关的工具和背景知识。


糟糕的沟通:紧张的描述 “我的 xxx 怎么不 xxx?”  “xxx 了怎么办?” 别人很难回答你的问题,必须继续追问你几个回合之后才知道你想表达什么。

有效的沟通:以不让别人追问为原则,描述清楚自己遇到的问题,所处的运行环境,如何复现。能够让别人复现你的场景非常重要。举个例子,前端的问题可以用 jsfiddle 复现,后端问题可以提供一个 docker 命令。

另外,报告问题的时候,最好能简洁清晰的证明问题。比如,我们提供了一个 HTTP 接口,用户如果报告这个接口的问题,最简单直观的方法就是发一个 cURL 命令,阐明预期的返回是什么,但是现在的返回是什么。很多人在报告问题的时候用的是截图、他们自己代码的日志,问题是,我们无法知道你的代码怎么写的,无法判断这个问题是你的代码造成的还是我们的服务造成的。所以最好的方式,就是使用一个第三方的工具,清楚得表明做的事情和目前的现象。


糟糕的沟通:截图一大片代码,中间包含某个报错。并问:为啥我的命令的结果是这样?

有效的沟通:贴出来这个命令一个结果的文字版本,然后提问。

除非是 GUI 方面的问题,一般人都会憎恨从图片中抄写代码。贴 URL 、代码以及转发,要优于贴图片。

如果一些 IM 工具对代码的格式化不好,(比如微信和钉钉),可以将代码写到 Gist 然后贴 Gist 的链接。甚至传文件也比截图要强。

有时候你要将别的群聊内容转发给另一个对象的话,尽量使用 IM 的转发功能,这样别人就可以知道上下文,知道前因后果。如果公司特别大,你经常遇到去问一个人A,A甩手让你去问B,B又让你问C的话,转发功能就比较好用了。

无论是在网络论坛,还是聊天,亦或是邮件,都应该善用引用能,提供原文的地址要优于复述原文。

粘贴命令行的文本的时候(通常是日志),要带上生成这些文本的命令。因为光看到这些结果,别人不知道这些结果代表什么意思,是怎么来的。但是如果带上了 grep example.com access.log ,这样的命令,不必描述,别人就可以理解文本代表什么含义了。

如果实在要截图的话,也要尽量带上原始的命令,不要只截取结果。


糟糕的沟通:文档中写:接口参数是xxx,URL是xxx。

不要指望你这么描述能够让一个 HTTP 接口没有歧义。更糟糕的是,我见过 HTTP 的文档上就贴了一个 Java 的 Class,并且里面的注释类似这样: private String button; // 按钮

有效的沟通:在写文档或者 IM 工具中,尽量用 cURL 或 HAR 交流参数信息。如果是 HTTP API 文档,在有条件的情况下,可以搭建像 Swagger 这样的 API 平台。向接口的提供方描述问题的时候,不要说我使用的xxx怎么不行?可以直接贴给对方你的 cURL 命令,这样它们就知道你发送的请求了。现代的浏览器,以及 postman insomnia 这种 API 工具,都支持将 HTTP 请求导出到 cURL。

除了 HTTP,其他的交流也可以使用命令。比如遇到磁盘问题,可以将 df 或者 mount 命令之类的作为信息提供给运维同事。命令优于口头描述。


糟糕的沟通:在吗?

有效的沟通:直接提供你的问题,尽可能描述对方可能用到的所有的信息,不让别人追问。

这一条尤为重要,否则可能会被同事当做神经病。


Firefox Setup

今天做了今年最重要的一个决定,从用了将近 10 年的 Chrome 换到 Firefox 了。主要是因为1)Chrome 太慢了,尤其是对于我这种喜欢打开 N 多个 tab 的人 2)Firefox 注重隐私。

这篇文章记录一些配置项目。

设置

Firefox 自带的网络功能非常强大, 在 Chrome 需要第三方进程和插件才能实现的功能,用 Firefox 内置的配置就可以实现。

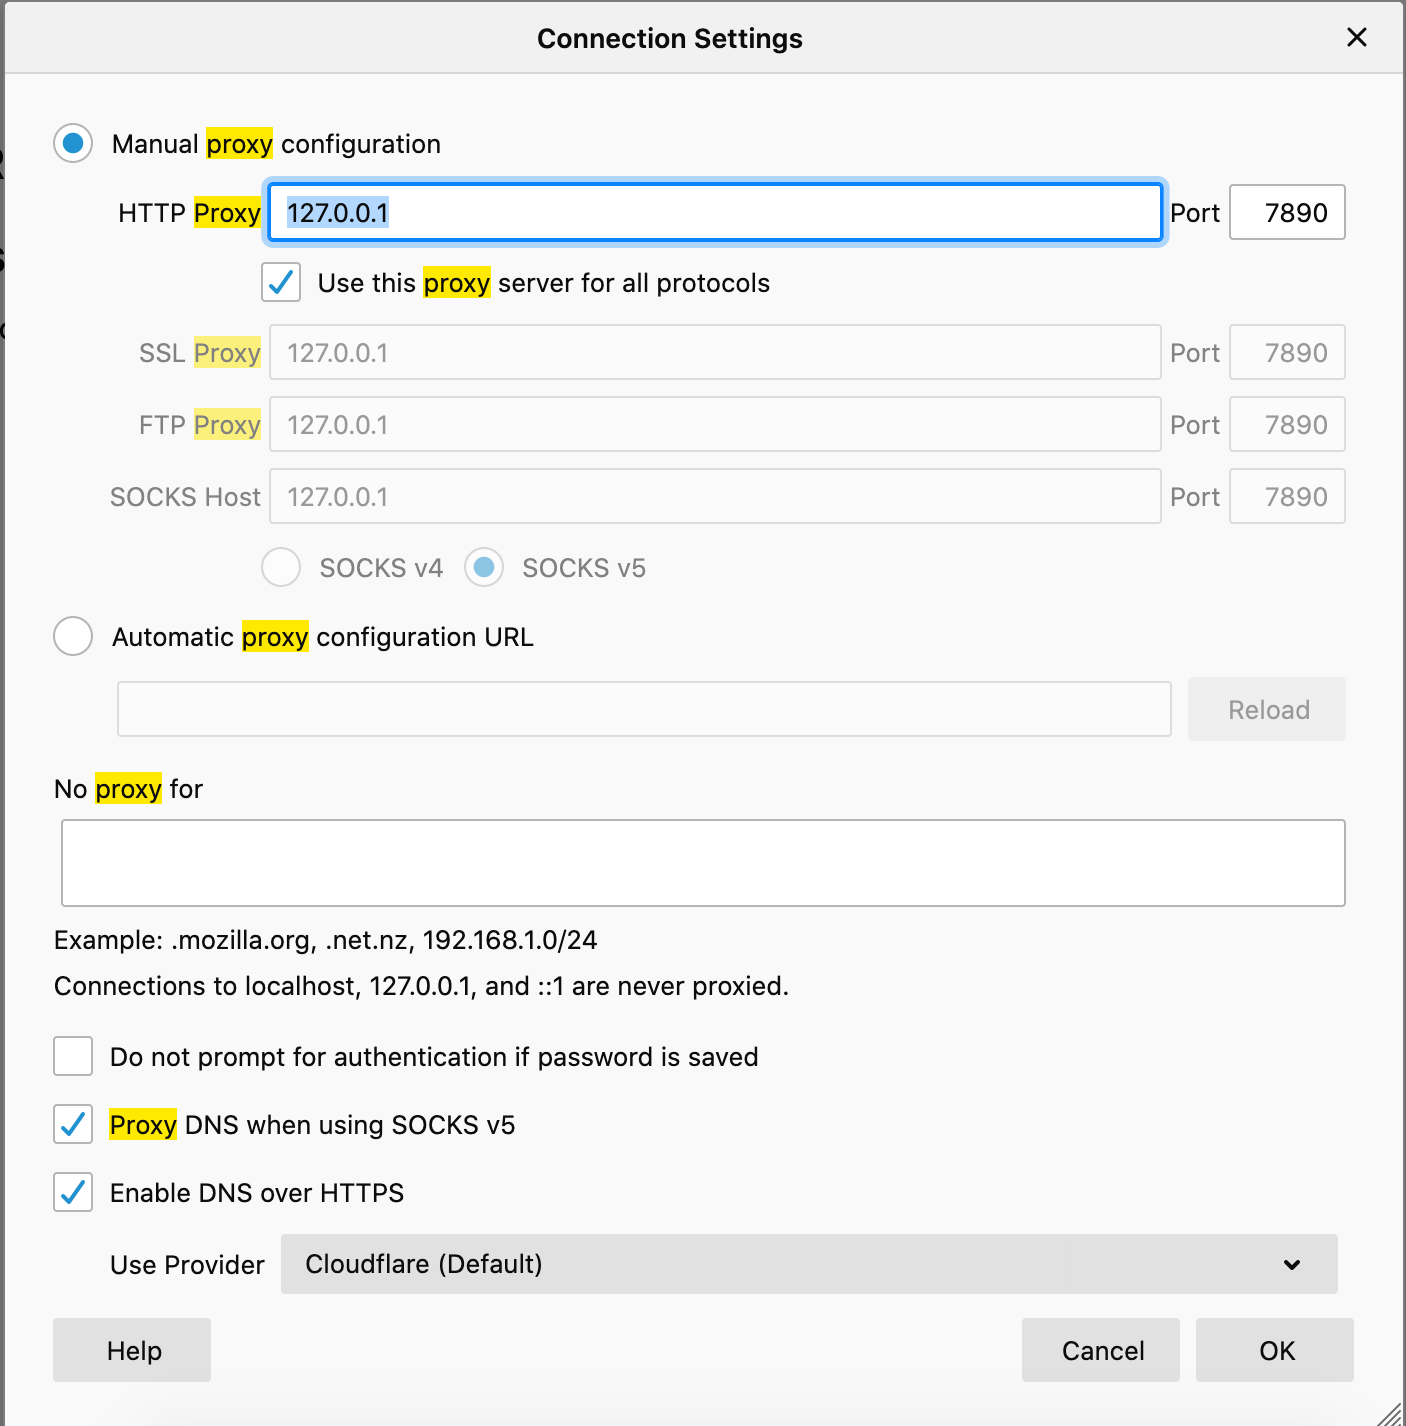
比如说可以不借助任何插件,直接将代理设置为 clash 的端口,将 DNS 设置为使用 CloudFlare 提供的 DNS over HTTPS。

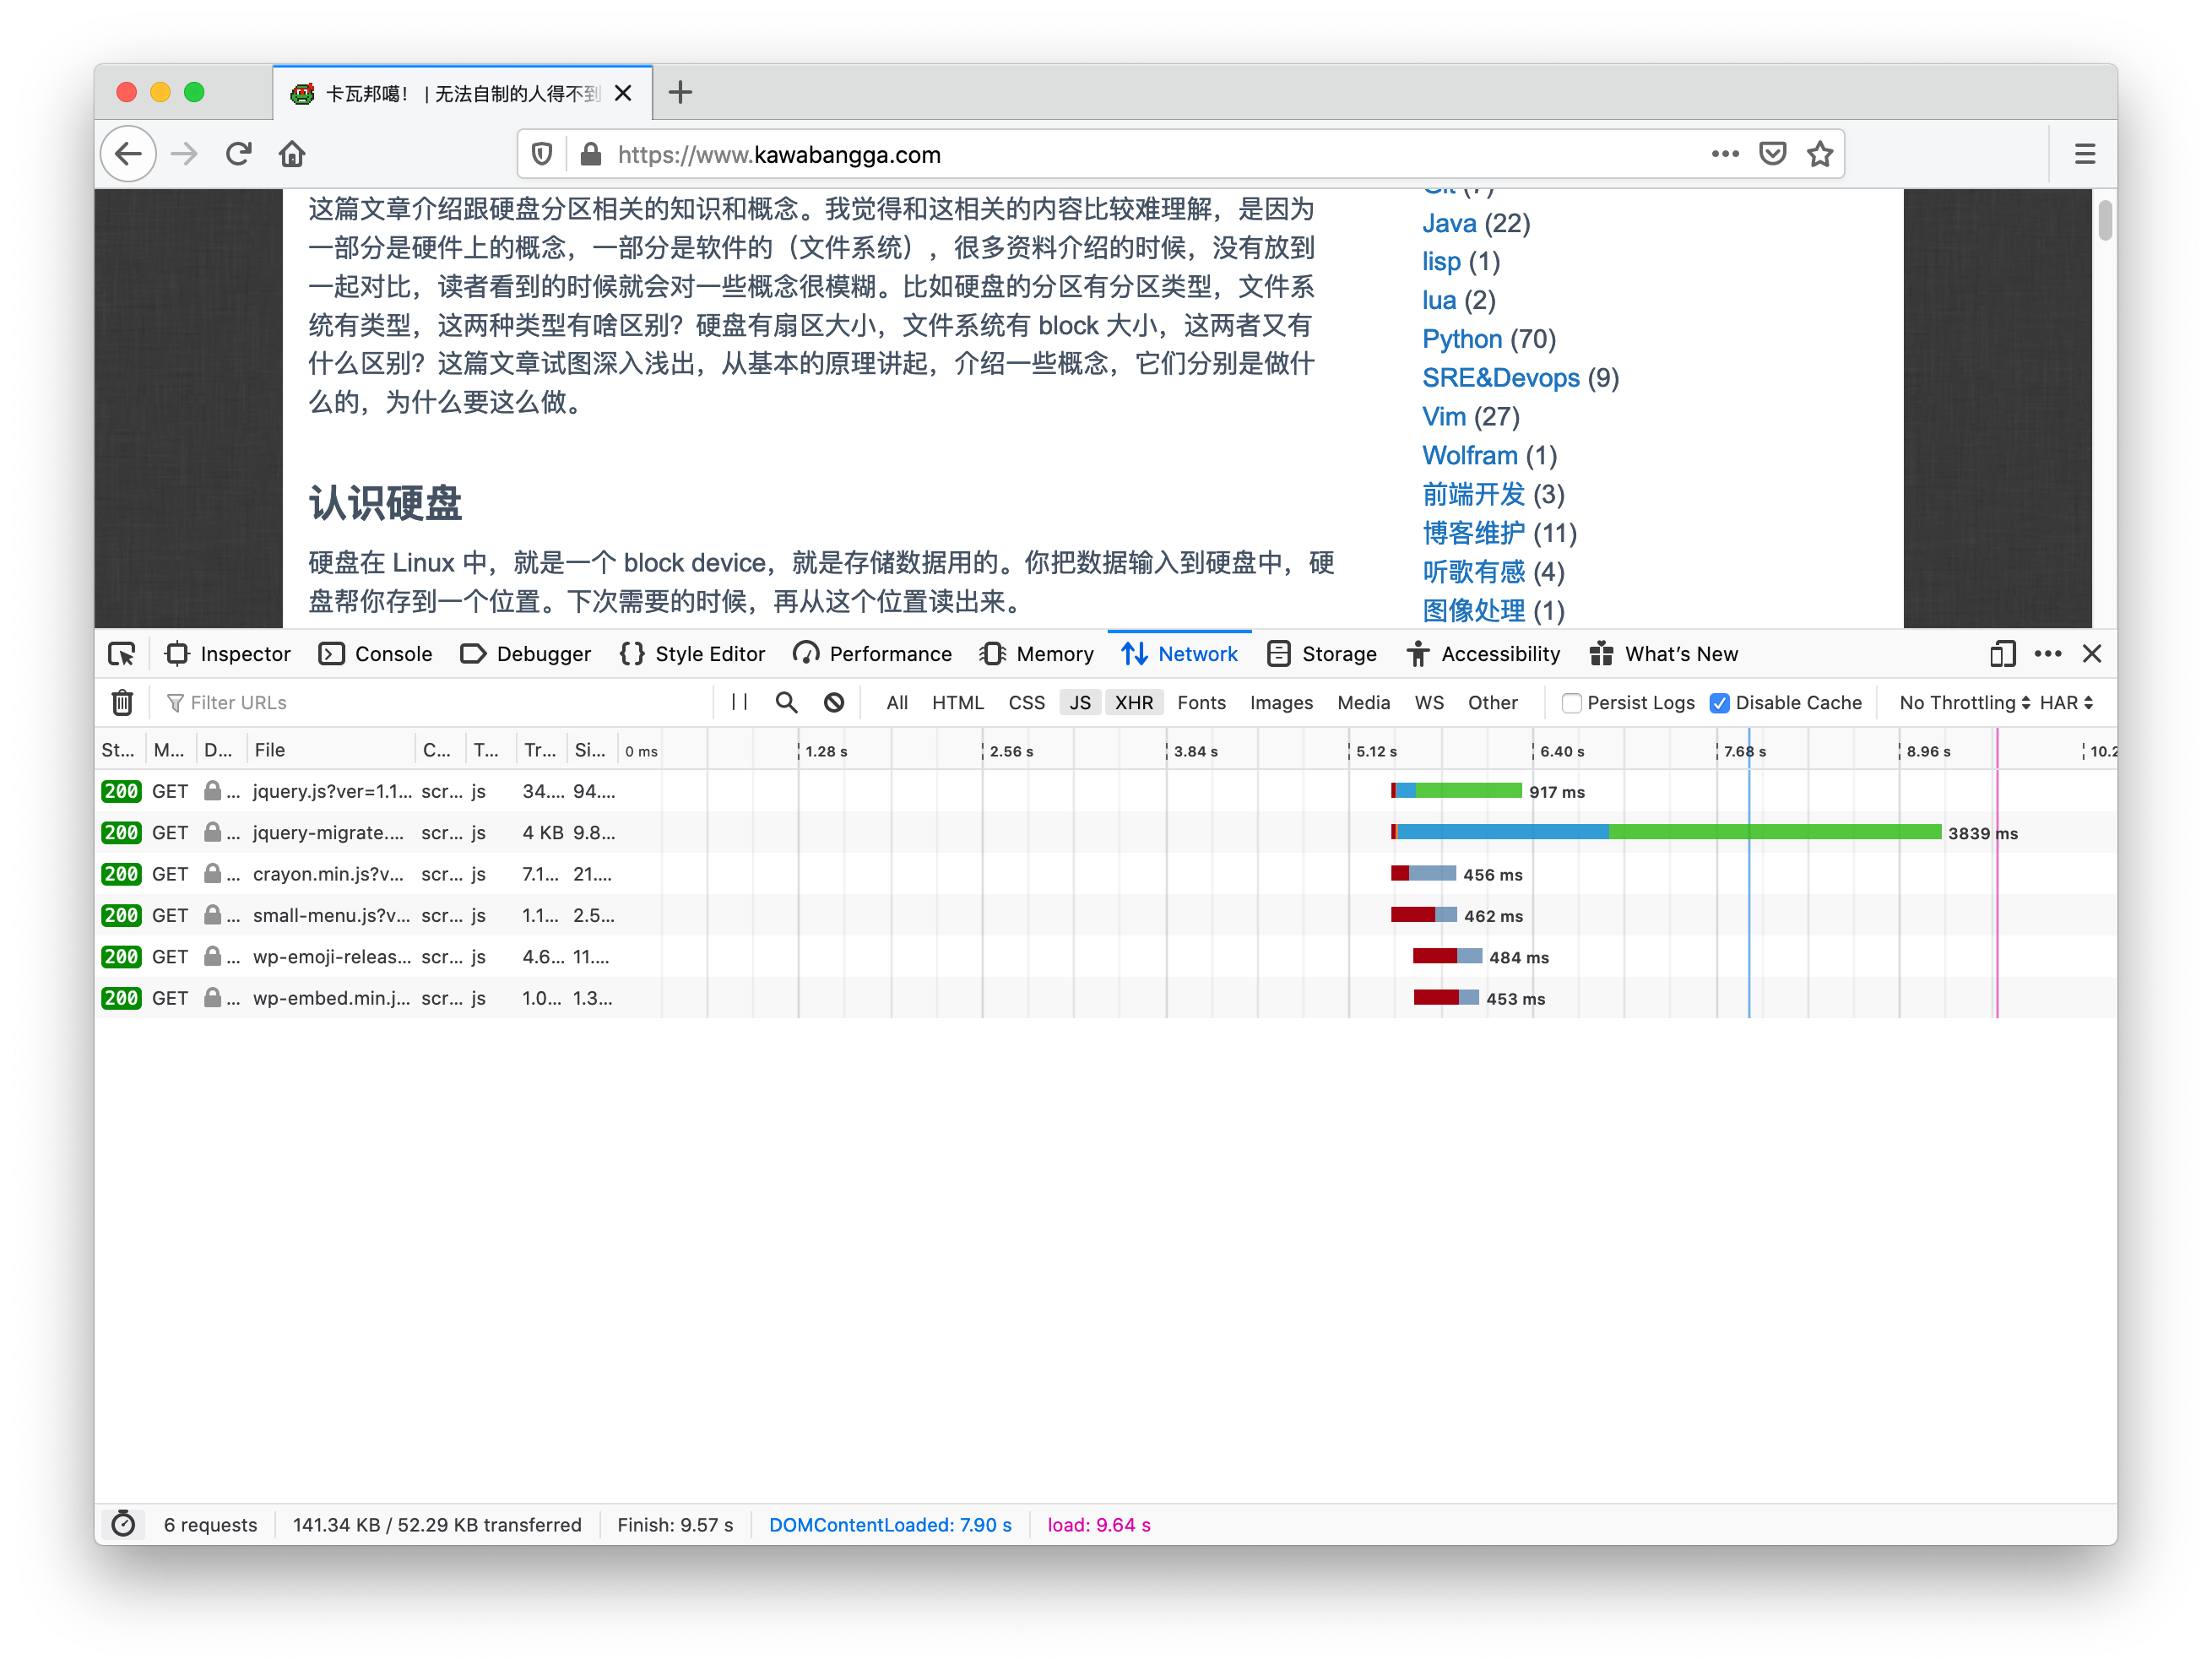
换到 Firefox 之后感觉网速变慢了,刚开始以为是我 DoH 的问题,打开控制台看了了一下并不是。大部分的请求前面都有一段 block 的时间。这里另外需要改一个参数。

Firefox 默认每个 domain 使用的连接数是 6,如果请求数超过了可用连接数,那么这些请求就会被 block 住。

图中深红色的时间就是客户端在等到其他请求释放连接的时间。

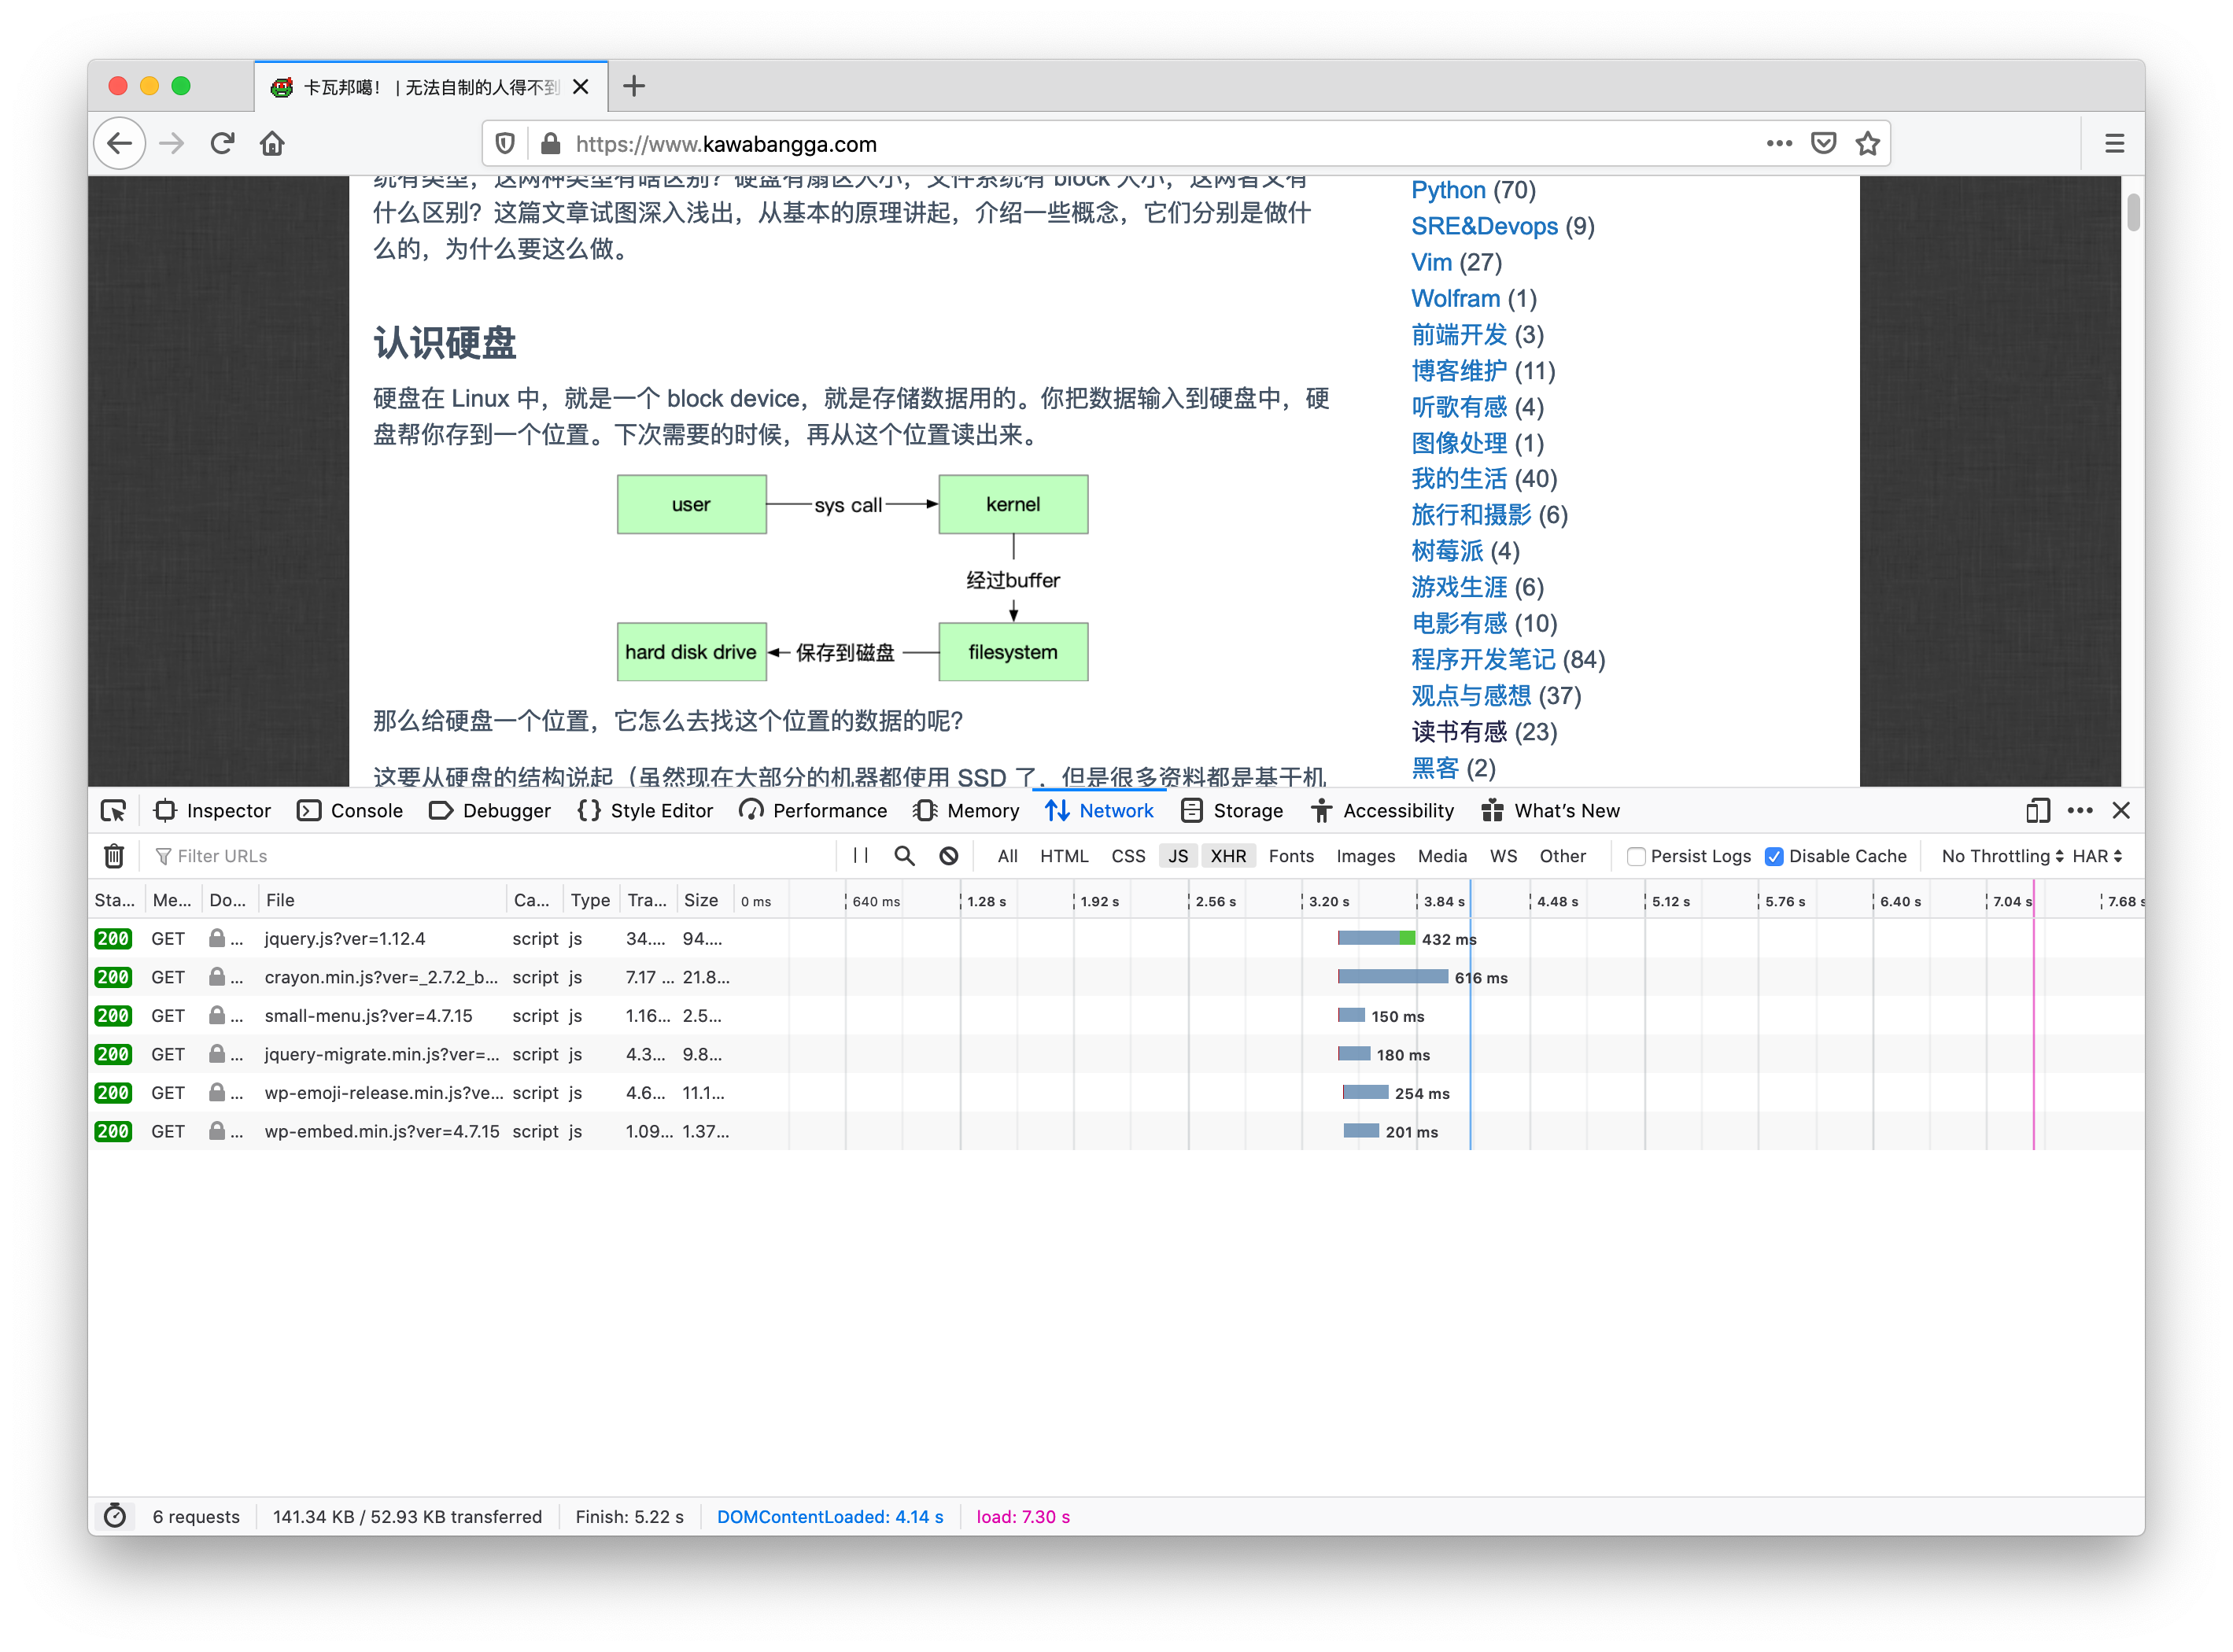
修改的方式是在地址栏输入 about:config 打开高级模式。搜索 Network.http.max-persistent-connections-per-server ,将其改成 1024 。需要重启 Firefox 生效。

可以看到重启之后已经没有等待连接的时间了。

我使用的插件

之前的 Firefox 如果安装很多插件,会影响启动速度。可能是因为每个插件都要占用一个 Container 进程吧。所以除非必须,我不安装一些胡里花哨的东西。

  1. 1Password X:  使用体验竟然比 Chrome 好很多;
  2. Default Bookmark Folder: 用它来添加书签的时候可以搜索位置,适合我这种收藏狂魔 + 整理癖;
  3. Ghostery – Privacy Ad Blocker:不光能屏蔽广告,还能屏蔽 tracker;
  4. Tampermonkey: 这个同 Chrome 一样;

版本

目前有以下版本:

我常用的是 firefox-developer-edition,也装了 nightly 和稳定版。

使用体验

其他优点:

  • Firefox 在打开很多 tab 的情况下,如果放不开了,tab 就会变成可以滑动的;而 Chrome 直接不显示最新的 tab 了;
  • Firefox 的页面滚动比较平滑;UI也比较好,添加书签,刷新,后退等都有动画;
  • 开发者工具友好,信息比较直观,格式化的很漂亮。比如开发者工具的 network 栏,Chrome 跟其相比就相当于一个古老的 jQuery 实现的 table,Firefox 就像一个响应式的 UI 一样。如果直接输入一个返回 Json 的 URL,Firefox 默认会启用一个 Json 格式化的工具,比大部分的 Chrome json 插件和 Json 格式化网站都要强;
  • 内置的跟网络相关的工具很全。比如内置的代理,内置的 DNS over HTTPS;
  • 竟然内置了 Pocket,更方便了;
  • 开发者工具很多地方都带一个问号标志,点击一下可以直接跳到 MDN 的文档;
  • 进程树洁净。只有主进程和一些插件生存的 Container 进程。不像 Chrome 要那么多 Render 进程要占一屏的 htop;

缺点:

  • 中文字体的渲染在 OS X 下,相比于 Chrome 有些模糊(也有可能是我的错觉),2K 显示器下有点模糊,但是 Mac 的显示器还是非常清楚的;
  • 我最喜欢的 WordPress 编辑器很多快捷工作都不工作了,比如用 - 自动切换到列表模式,`` 改成代码样式等;
  • 一些网站的开发者用 Chrome,导致这些网站只在 Chrome 下工作,比如微信,在 Firefox 下聊天会遇到无法看到消息的 BUG;


就想到这些,以后朋友有用的 trick 再分享。

再见了,Chrome。


2019年12月08日更新:

网页版微信有巨大 BUG:聊天框会挂;网页版 微博在 firefox 登陆不上,微博也太烂了。

发现 Firefox 有 Container 功能,太实用了。测试自己网站的另外一个账号再也不用开隐身模式了,直接开 Container 就好了,相当于是 Cookie 完全不同的另一个浏览器,网站多账号轻松实现。


硬盘分区介绍

这篇文章介绍跟硬盘分区相关的知识和概念。我觉得和这相关的内容比较难理解,是因为一部分是硬件上的概念,一部分是软件的(文件系统),很多资料介绍的时候,没有放到一起对比,读者看到的时候就会对一些概念很模糊。比如硬盘的分区有分区类型,文件系统有类型,这两种类型有啥区别?硬盘有扇区大小,文件系统有 block 大小,这两者又有什么区别?这篇文章试图深入浅出,从基本的原理讲起,介绍一些概念,它们分别是做什么的,为什么要这么做。

认识硬盘

硬盘在 Linux 中,就是一个 block device,就是存储数据用的。你把数据输入到硬盘中,硬盘帮你存到一个位置。下次需要的时候,再从这个位置读出来。

那么给硬盘一个位置,它怎么去找这个位置的数据的呢?

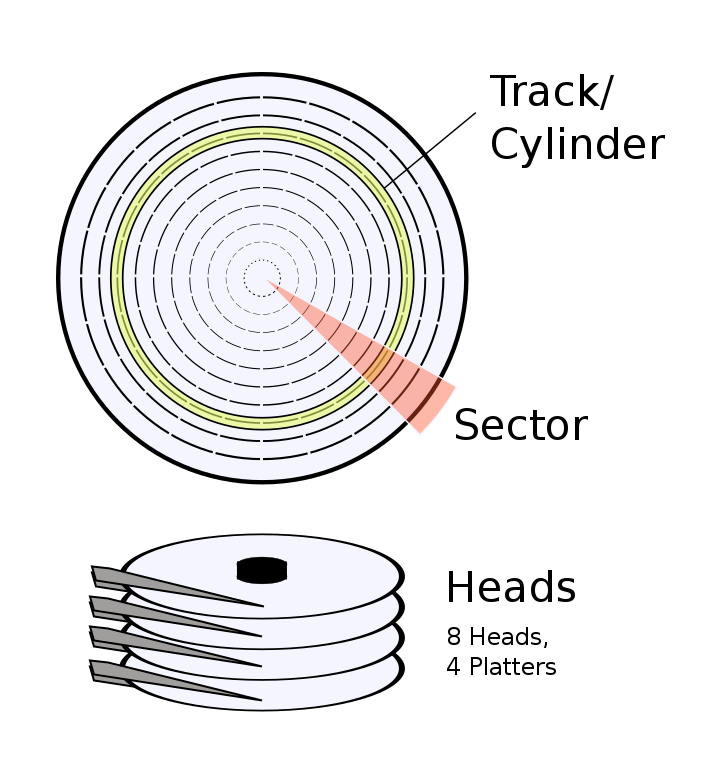
这要从硬盘的结构说起(虽然现在大部分的机器都使用 SSD 了,但是很多资料都是基于机械硬盘的,所以这里以机械硬盘为例,介绍一下 CHS 寻址的原理。)。硬盘是由几张碟片组成的,每张碟片的正反两面都可以保存数据。

所以这个问题就转换成了:在几个圆面中,如何确定一个位置。首先我们想,在一个圆面中,确定一个位置需要几个参数?很显然是2个,距离圆心的距离可以确定一个圆,再加上一个“角度”可以确定这个圆上的一个点。那么在硬盘的结构中,再加上一个参数确定是第几个圆面就可以了。

这几个参数我们分别叫它:

  • Cylinder/Track:磁道,柱面,确定距离圆心的位置;
  • Head: 磁头,这个是读写数据的物理装置,实际上硬盘在运行的时候,是盘片在转的,磁头负责移动,调整读取的柱面;
  • Sector: 扇区。上面两个参数确定了一个圆形,Sector 就可以确定这个圆形中哪个扇区了。

这就是 CHS 寻址的方式。

从中可以也看出,硬盘存储的读写单位是“一个扇区”。实际上,在分区的时候,(分区软件)也会用“第几个到第几个扇区”来表示,不会让你涉及到 Track 和 Head 的,这是属于硬件自己用来寻址的东西。

使用 fdisk 我们可以看到硬盘有多少个扇区,一个扇区多大。实际上从 1980 年以来,几乎所有的硬盘扇区大小都是 512bytes。(@yiran 纠正:现在一些新磁盘的物理扇区是 4k 了,系统中看到的逻辑扇区是512字节)

$ fdisk -l
Disk /dev/sda: 64 GiB, 68719476736 bytes, 134217728 sectors
Disk model: VBOX HARDDISK
Units: sectors of 1 * 512 = 512 bytes
Sector size (logical/physical): 512 bytes / 512 bytes
I/O size (minimum/optimal): 512 bytes / 512 bytes
Disklabel type: dos
Disk identifier: 0x86ae6277

Device Boot Start End Sectors Size Id Type
/dev/sda1 2048 4542463 4540416 2.2G 82 Linux swap / Solaris
/dev/sda2 * 4542464 35999743 31457280 15G 83 Linux

为什么要分区?

现在我们知道有了扇区的位置,硬盘就可以把数据写入或读出。那为什么要分区呢?原因以下几点:

  • 隔离文件系统的腐烂(鸡蛋不放在一个篮子里)。我们要在设备上建立文件系统,操作系统才能使用文件系统来读写。文件系统是对存储设备的规划,记录着每一块都存了什么(inode, block)。万一文件系统的元数据错乱了,那么整个文件系统的数据可能都读不到了;
  • 提高存储的利用率。参考之前的博文:Linux 文件系统 inode 介绍,一个文件最小将占用一个 block,如果 block 太大的话,将会浪费很多空间。比如 block size 是 4k,而存储的都是 1k 的文件,那么有 3/4 的空间是浪费的。如果 block 太小,那性能就很低,因为 kernel 是以 block 为单位拷贝的;我们可以分一个区,建一个 block size 为 512bytes 的文件系统来专门存储这些小文件;
  • 限制文件增长。crontab 写日志太多了导致所有的进程都挂了,这肯定是不合理的。但是文件的增长不会越过文件系统,跑到另一个分区上,所以我们可以通过分区,来给特定的进程分配写空间。

基于此,我们可以在系统中为不同的存储内容划分区。比如为用户程序 /usr 单独分区,/home 单独分区。

分区的本质是什么?

不同的分区还是在一块硬盘上,相当于是对不同的扇区分组管理罢了。那么这个分组信息保存在哪里呢?

答案是第一个硬盘的第一个扇区上。硬盘的第一个扇区也是系统启动的时候第一个读的地方(基于 BIOS 的启动流程)。前面说到,一个扇区的大小是 512bytes,这 512bytes 都有什么呢?

在 Linux 中一切都是文件,硬盘也是一个文件,用 /dev/sda 表示(这是 SCSI 接口,IDE 接口会是 /dev/hda ,具体命名方式和编号见此)。这样,我们就可以将这个“文件”的前 512bytes 拷贝出来。

$ dd if=/dev/sda of=mbr.bin bs=512 count=1
1+0 records in
1+0 records out
512 bytes copied, 0.000308004 s, 1.7 MB/s

然后可以用 Vim 带的 xxd 命令看一下这个文件的内容:

$ xxd mbr.bin
00000000: eb63 9010 8ed0 bc00 b0b8 0000 8ed8 8ec0  .c..............
00000010: fbbe 007c bf00 06b9 0002 f3a4 ea21 0600  ...|.........!..
00000020: 00be be07 3804 750b 83c6 1081 fefe 0775  ....8.u........u
00000030: f3eb 16b4 02b0 01bb 007c b280 8a74 018b  .........|...t..
00000040: 4c02 cd13 ea00 7c00 00eb fe00 0000 0000  L.....|.........
00000050: 0000 0000 0000 0000 0000 0080 0100 0000  ................
00000060: 0000 0000 fffa 9090 f6c2 8074 05f6 c270  ...........t...p
00000070: 7402 b280 ea79 7c00 0031 c08e d88e d0bc  t....y|..1......
00000080: 0020 fba0 647c 3cff 7402 88c2 52be 057c  . ..d|<.t...R..|
00000090: b441 bbaa 55cd 135a 5272 3d81 fb55 aa75  .A..U..ZRr=..U.u
000000a0: 3783 e101 7432 31c0 8944 0440 8844 ff89  [email protected]..
000000b0: 4402 c704 1000 668b 1e5c 7c66 895c 0866  D.....f..\|f.\.f
000000c0: 8b1e 607c 6689 5c0c c744 0600 70b4 42cd  ..`|f.\..D..p.B.
000000d0: 1372 05bb 0070 eb76 b408 cd13 730d 5a84  .r...p.v....s.Z.
000000e0: d20f 83de 00be 857d e982 0066 0fb6 c688  .......}...f....
000000f0: 64ff 4066 8944 040f b6d1 c1e2 0288 e888  [email protected]..........
00000100: f440 8944 080f b6c2 c0e8 0266 8904 66a1  [email protected].
00000110: 607c 6609 c075 4e66 a15c 7c66 31d2 66f7  `|f..uNf.\|f1.f.
00000120: 3488 d131 d266 f774 043b 4408 7d37 fec1  4..1.f.t.;D.}7..
00000130: 88c5 30c0 c1e8 0208 c188 d05a 88c6 bb00  ..0........Z....
00000140: 708e c331 dbb8 0102 cd13 721e 8cc3 601e  p..1......r...`.
00000150: b900 018e db31 f6bf 0080 8ec6 fcf3 a51f  .....1..........
00000160: 61ff 265a 7cbe 807d eb03 be8f 7de8 3400  a.&Z|..}....}.4.
00000170: be94 7de8 2e00 cd18 ebfe 4752 5542 2000  ..}.......GRUB .
00000180: 4765 6f6d 0048 6172 6420 4469 736b 0052  Geom.Hard Disk.R
00000190: 6561 6400 2045 7272 6f72 0d0a 00bb 0100  ead. Error......
000001a0: b40e cd10 ac3c 0075 f4c3 0000 0000 0000  .....<.u........
000001b0: 0000 0000 0000 0000 7762 ae86 0000 0004  ........wb......
000001c0: 0104 82fe c2ff 0008 0000 0048 4500 80fe  ...........HE...
000001d0: c2ff 83bb c1bb 0050 4500 0000 e001 0000  .......PE.......
000001e0: 0000 0000 0000 0000 0000 0000 0000 0000  ................
000001f0: 0000 0000 0000 0000 0000 0000 0000 55aa  ..............U.

这里面的内容可以分成4部分:

  1. 001-440bytes(一共 440bytes):给 BIOS 执行的代码; 这个其实很有意思,感兴趣的朋友可以将这段 dump 成机器码看一下。启动系统需要将代码加载到内存,但是我们需要系统启动才能加载代码。所以这个过程又叫做 boot,即 “pull oneself over a fence by one’s bootstraps”。
  2. 441-446bytes(一共 6bytes):MBR Disk 签名;
  3. 447-510(一共 64bytes):分区表,一共 4 部分,每部分16 bytes;
  4. 最后的 511 和 512(一共2bytes):固定为 0x55AA,表示硬盘可以用于启动;

从 00001be 到最后 00001fd 之间,记录的都是分区表的信息。

  • 分区1: 0004 0104 82fe c2ff 0008 0000 0048 4500
  • 分区2: 80fe c2ff 83bb c1bb 0050 4500 0000 e001
  • 分区3:0000 0000 0000 0000 0000 0000 0000 0000
  • 分区4:0000 0000 0000 0000 0000 0000 0000 0000

根据上面 fdisk -l 显示,我这个机器只有两个分区,所以分区3和4是空的。这 16bytes 里面都记录的什么呢?我们拿其中一个分区来说明,这里就用第2个分区说吧:

80fe c2ff 83fe c1bb 0050 4500 0000 e001

0字节,80,是一个标志:

  • 80 此分区可以用于系统启动;
  • 00 此分区不能用于系统启动;

1-3字节,fe c2ff 这就是用我们上面说的 CHS 地址表示,以及后面的 5-7 字节,分别表示此分区开始的位置是:

  • fe Cylinder位置是 fe;
  • c2 Head 开始位置是 c2;
  • ff Sector 开始位置是 ff;

相应的,这个分区的结束位置是 bb c1 bb。

开始和结束中间的第4字节,是分区类型。在这里是 83 ,表示 type 是 Linux.

在 fdisk 中可以通过 l 命令列出所有的 type:

Command (m for help): l

 0  Empty           24  NEC DOS         81  Minix / old Lin bf  Solaris
 1  FAT12           27  Hidden NTFS Win 82  Linux swap / So c1  DRDOS/sec (FAT-
 2  XENIX root      39  Plan 9          83  Linux           c4  DRDOS/sec (FAT-
 3  XENIX usr       3c  PartitionMagic  84  OS/2 hidden or  c6  DRDOS/sec (FAT-
 4  FAT16 <32M      40  Venix 80286     85  Linux extended  c7  Syrinx
 5  Extended        41  PPC PReP Boot   86  NTFS volume set da  Non-FS data
 6  FAT16           42  SFS             87  NTFS volume set db  CP/M / CTOS / .
 7  HPFS/NTFS/exFAT 4d  QNX4.x          88  Linux plaintext de  Dell Utility
 8  AIX             4e  QNX4.x 2nd part 8e  Linux LVM       df  BootIt
 9  AIX bootable    4f  QNX4.x 3rd part 93  Amoeba          e1  DOS access
 a  OS/2 Boot Manag 50  OnTrack DM      94  Amoeba BBT      e3  DOS R/O
 b  W95 FAT32       51  OnTrack DM6 Aux 9f  BSD/OS          e4  SpeedStor
 c  W95 FAT32 (LBA) 52  CP/M            a0  IBM Thinkpad hi ea  Rufus alignment
 e  W95 FAT16 (LBA) 53  OnTrack DM6 Aux a5  FreeBSD         eb  BeOS fs
 f  W95 Ext'd (LBA) 54  OnTrackDM6      a6  OpenBSD         ee  GPT
10  OPUS            55  EZ-Drive        a7  NeXTSTEP        ef  EFI (FAT-12/16/
11  Hidden FAT12    56  Golden Bow      a8  Darwin UFS      f0  Linux/PA-RISC b
12  Compaq diagnost 5c  Priam Edisk     a9  NetBSD          f1  SpeedStor
14  Hidden FAT16 <3 61  SpeedStor       ab  Darwin boot     f4  SpeedStor
16  Hidden FAT16    63  GNU HURD or Sys af  HFS / HFS+      f2  DOS secondary
17  Hidden HPFS/NTF 64  Novell Netware  b7  BSDI fs         fb  VMware VMFS
18  AST SmartSleep  65  Novell Netware  b8  BSDI swap       fc  VMware VMKCORE
1b  Hidden W95 FAT3 70  DiskSecure Mult bb  Boot Wizard hid fd  Linux raid auto
1c  Hidden W95 FAT3 75  PC/IX           bc  Acronis FAT32 L fe  LANstep
1e  Hidden W95 FAT1 80  Old Minix       be  Solaris boot    ff  BBT

但其实,这个分区类型在 Linux 中用处并不大,无论是 ext2 还是 ext3 还是其他 Linux 分区,都是 83。这个标志位不同的操作系统有不同的解释方法,比如 Windows,会用这个标志来区分不同的分区类型,所以你看到在这个表中,FAT32 和 NTFS 这些常见的 Windows 分区都分别占用了一种标志位。说到底,这个标志位其实就是个普通的标志,怎么解释归操作系统的,甚至不同的操作系统安装在同一个硬盘上也是可行的,比如 0x07 ,OS/2 认为这个标志位是 HPFS 类型的分区,Windows 认为是 NTFS 类型的分区。

要注意的是,这个标志位和文件系统并没有本质的关系。既然 Linux 不关心这个标志位,那么无论这个分区的类型是什么,我都可以在这上面建一个文件系统。甚至我可以在系统运行的时候覆盖写入这个标志位。比如我把当前的这个分区改成 FAT12,也是一点问题都没有的。

Device     Boot    Start      End  Sectors  Size Id Type
/dev/sda1           2048  4542463  4540416  2.2G 82 Linux swap / Solaris
/dev/sda2  *     4542464 35999743 31457280   15G  1 FAT12
/dev/sda3       35999744 38096895  2097152    1G 83 Linux

8-11字节:0050 4500 逻辑 block 地址的第一个扇区的绝对地址。

11-15字节:0000 e001 此分区一共有多少个扇区。

MBR 分区的限制:从这里可以看出,4个字节表示第一扇区的绝对地址,4个字节表示此分区有多少个扇区,那么 MBR 分区表最多可以支持的硬盘大小是:

512Bytes * 0xff ff ff ff          + 512Bytes * 0xff ff ff ff
扇区大小    最大能表示的第一个扇区位置    扇区大小    最后一个分区的最大扇区数

即 512 * (2^32 -1 ) * 2 ,是 4TiB -1Kb。

然而,这样分区的话,必须要最后一个分区是 2TiB,这样才能利用起 4Tib。如果一个用户有一个 4TiB 的硬盘,想要平均分成4区,每个分区 1TiB,是不行的。这会对很多用户造成困惑,所以在商业宣传的时候,就直接说 MBR 支持 2TiB。参考1 参考2 yiran补充

主分区和扩展分区

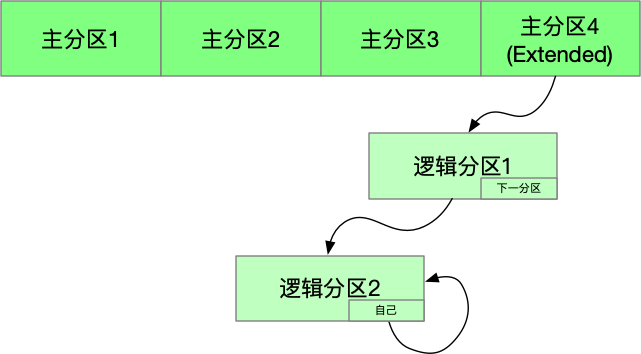
从这里也可以看出,分区数据一共 64bytes,每个分区表需要 16bytes 的信息。那么一共可以有 4 个分区。我第一次用电脑的时候,是 Windows,一直不明白“本地磁盘 CDEF”是什么意思。其实就是分区软件的快速分区模式默认平均将硬盘分了4个区而已。

分区表决定了我们只能创建 4 个分区,如果我们想要更多的分区怎么办?

还记得在文件系统中 block 寻址的时候如果超过 inode 能存放的 block 怎么办吗?答案是:inode 存放的 block,实际的内容是指向真正的 block 的地址。这里也用了同样的原理,我们可以创建一个类型为 Extended 类型(标志位是 5)的主分区,然后这个分区中每个分区的最后都保存着指向下一个分区的地址。

逻辑分区必须是连续的(显而易见),但是主分区可以不连续。除此之外逻辑分区和主分区在使用上并没有差别。逻辑分区也可以启动系统。

介绍到这里,应该能解决读者大部分的问题了(至少这些内容回答了我的很多疑问)。更加深入的问题,可能就要读者基于这些内容,自行搜索更详细的资料了。

扇区大小和Block大小

看文本文你应该对这个问题有所了解,扇区是一个硬盘的概念,几乎所有的硬盘扇区都是 512Bytes,如果不是,可能会出问题的。而 Block 指的是一个逻辑上的概念。但是可能在一些情景下依然对它们有些困惑。我研究了一番相关的内容,所以在这里多少一些,以便将来跟我有同样疑问的朋友,能找到这里,节省一些时间。

扇区大小的概念,出入很小。但是 Block 在不同的情景下是有不同的含义的。

首先是文件系统的 block,这里的 block 会影响存储文件使用的 block 大小。道理很简单,文件系统以 block 为单位寻址,如果 block 大小为 4k,那么即使文件写入 1k,也需要占用 4k。

创建文件系统,会自动分配 inode 和 block:

$ mkfs -t ext2 /dev/sda5
mke2fs 1.45.3 (14-Jul-2019)
Creating filesystem with 131072 1k blocks and 32768 inodes
Filesystem UUID: eac2bf41-3564-4f66-8740-e574593247fa
Superblock backups stored on blocks:
        8193, 24577, 40961, 57345, 73729

Allocating group tables: done
Writing inode tables: done
Writing superblocks and filesystem accounting information: done

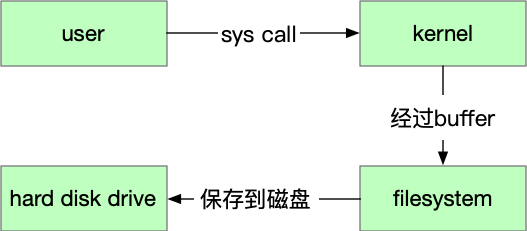
IO 中的 block:IO 是以 block 为单位的,这个 block 不一定是文件系统的 block 大小,也不一定是扇区的大小,可以比扇区更小,但是这是一种浪费,因为硬盘每次写会写 512bytes,如果 IO 的 block 是 256bytes,那么相当于写入相同一个扇区的内容,用了两次物理写入操作。此外,我们写入磁盘必须经过 syscall,在用户空间和 kernel 空间之间拷贝数据,也是以 block 为单位。我们可以用 madvice 这个系统调用向 Kernel 建议 IO block size。

以下是我用 dd 从硬盘拷贝相同的数据,使用不同的 block size,可以见期速度的影响。

$ dd if=/dev/sda of=dump.bin bs=200 count=1000
1000+0 records in
1000+0 records out
200000 bytes (200 kB, 195 KiB) copied, 0.0111036 s, 18.0 MB/s
$ dd if=/dev/sda of=dump.bin bs=512 count=1000
1000+0 records in
1000+0 records out
512000 bytes (512 kB, 500 KiB) copied, 0.00905283 s, 56.6 MB/s
$ dd if=/dev/sda of=dump.bin bs=1024 count=1000
1000+0 records in
1000+0 records out
1024000 bytes (1.0 MB, 1000 KiB) copied, 0.0061073 s, 168 MB/s

但是 IO 其实是一个很复杂的问题,三言两语是说不清楚的,推荐一本书 Linux System Programming,里面用了四章介绍 IO 相关的话题。

除此之外,在看到 block 的时候,你还要注意它说的是什么语境。比如 ls -s 命令展示的 block,是以每个 block=1024bytes 展示的,而 stat 里面的 block 是 512bytes。

$ ls -s a.txt
4 a.txt
$ stat a.txt
  File: a.txt
  Size: 6               Blocks: 8          IO Block: 4096   regular file
Device: 802h/2050d      Inode: 656578      Links: 1
Access: (0644/-rw-r--r--)  Uid: (    0/    root)   Gid: (    0/    root)
Context: unconfined_u:object_r:user_home_t:s0
Access: 2019-12-01 09:49:27.651029032 +0000
Modify: 2019-12-01 09:51:26.508134896 +0000
Change: 2019-12-01 09:51:26.508134896 +0000
 Birth: 2019-12-01 09:49:27.651029032 +0000

建议用相关工具实践一下分区,建议在虚拟机里面操作,不用担心搞坏宿主机。玩一下这些命令:

  • xxd (vim提供)
  • fdisk
  • mount
  • grub
  • ss
  • dd

这篇文章参考的资料:

  1. Linux Partition HOWTO
  2. 分区标志
  3. Parition Types
  4. Linux System Administrators Guide: Chapter 5. Using Disks and Other Storage Media
  5. Linux 是如何启动的?
  6. Linux MBR
  7. 分区类型和文件系统类型的区别
  8. 如何确定 block size