编译LFS的一些经验

LFS 全称叫做 Linux From Scratch ,顾明思议,就是“从头开始的 Linux”。官方网址 中文翻译网址

LFS 可以说是一个项目,也可以说是一本书。它会教你如何从头构建你自己的 Linux 发行版。这里说的“从头”,是纯粹的从头的,包括编译工具,也是需要自己构建出来的。比如 Gcc,这是整个构建过程中比较核心的工具,LFS 先从 Gcc 源码编译了一个 Gcc,又编译了一个 Glibc。因为 Libstdc++ 是依赖 Glibc 的,所以有了 Glibc 之后,才可以第二次编译 Gcc(这次带上 Libstdc++)。其他工具也是一样,这样就有了一个临时的工具集。当编译一个 Linux 所有的工具链都准备好之后,就用 chroot 进入临时的系统,独立于宿主系统。在这个临时系统中编译 Linux。即,这个工具从编译工具到最后 boot 启动成功,都是需要自己编译的,没有使用现成的 binary。

LFS 让我感到很惊艳,这是个了不起的工程。从上面的例子可以看出,这个工程需要经验老到的梳理很多循环依赖,和编译错误。

现在的编程世界有了各种方便的包管理工具,和提前编译好的二进制文件。一般我们需要什么工具,只要找对应平台的二进制来下载使用就好了。却从来没有想过,如果“从头”编译一个东西会是怎样的。会不会有一天,像《基地》里面的帝国那样,机器都无比复杂,没有任何一个人清楚怎么修理,而导致帝国的崩坏呢?

小时候我经常陷入这样的幻想:如果从零制作一个东西,会是怎么样的。比如说桌子,造桌子需要斧头,和钉子,这些又需要钢铁,那么就需要炼钢。炼钢技术需要有火,还有要XX等等。这个项目,也算满足了我的一个幻想。

废话了这么多,只想跟大家推荐一下 LFS,真的很值得一试。即使最后你不使用最终构建的 Linux 作为自己日常使用的 Linux,从中也能学到很多东西。比如,我今天从这个项目中才知道 su - 后面的这个 - 是什么含义。

这篇博客,也记录一下我构建 LFS 时候的一些坑,因为我发现中文方面的资料和讨论比较少。希望对后面去玩 LFS 的人有些帮助。

环境问题

我是在 Mac 上,使用 VirtualBox 虚拟化出来的 Fedora 构建的(推荐大家这么做)。也可以直接使用 Linux 系统编译,不用虚拟化和 Docker 啥的,因为书里面就会教你如何构建一个纯净的工具系统。但是不推荐用 OS X 来构建,APFS 会有很多坑。

最开始需要分区,挂载到宿主系统。我在虚拟机里面没有搞定,然后想起来,我在 Virtualbox 里面呀!遂直接用 Virtualbox 挂载了一个新的硬盘上去。搞定。

第一次编译 LFS 尽量不要自己做定制,严格按照书上的来,不然可能会白费一些力气。

下载

要下载的内容基本都是源代码,在准备的章节中,LFS 整理了一个 URL 列表,可以直接用 wget 下载。我发现即使用代理,有些下载还是很慢,2个小时都没下载完。后来直接去 DigitalOcean 开了一台 VPS,3min就下完了。推荐还是用外网的机器直接下载然后 scp 拷贝回来吧。

机器配置

LFS 每一个工具的构建都写的很标准,标明了构建耗时。用的单位是 SBU (Standard Build Unit),表示时间需要构建 BinUtils 的几倍长。有些构建相当耗时,我一开始给构建用的机器分配了 2CPU/8G MEM ,最后加到了 4CPU/8G MEM。但是还是觉得挺慢,所以推荐大家有多少资源就给多少吧。LFS 整个过程大多数时间都在等待编译完成。

在 LFS 中可以学到什么

尽量看懂书里面的每一行脚本,和解释,能学到很多东西的,不要急着粘贴命令。

The key to learning what makes a Linux system work is to know what each package is used for and why you (or the system) may need it.

操作仔细

注意一下编译的输出。由于编译太耗时了,有可能编译结束的时候,就忘记自己当前在哪一步了。一定要仔细一些,我有次 make 之后忘记执行 make install 了,其实后面执行命令的时候,通过 ./configure 输出,可以看到某些工具用的不是工具链里面,是系统里面的,是可以提前发现的。LFS 越到后面,发现错误的成本越大。轻则需要从错误处再走一遍,重则找不到错误的源头,功夫白费了。

编译完第5章建议备份一下 $LFS/tools ,以后编译别的东西可以直接用这个工具链。

一些可能的坑

  • 进入第六章之后,如果中途中断了(总不能一口气编译完吧)。下次进入的时候要重新操作 6.2 和 6.4,进行 mount 和进入 chroot 和 mount 一些虚拟文件系统;

    If the virtual kernel file systems have been unmounted, either manually or through a reboot, ensure that the virtual kernel file systems are mounted when reentering the chroot. This process was explained in Section 6.2.2, “Mounting and Populating /dev” and Section 6.2.3, “Mounting Virtual Kernel File Systems”.

  • 即使编译 stable 版本的 LFS,也可能遇到一些书中没有标明的测试失败。只要不是大面积的失败,几个失败可能并不是重要的。我编译的过程中遇到的未预期的测试失败记录在这里了,供后面的人参考。
  • 推荐使用 virtualbox 添加一块新盘来做,这样即使 host 机器有什么问题(比如 grub 设置错误导致无法启动),可以很方便的将这个新盘 mount 到另外一台虚拟机,直接更改里面文件。
  • 如果使用 virtualbox 的话,在设置 grub 的时候,要注意将 grub 安装到 /dev/sda,然后 boot 的磁盘添加 /dev/sdb.

相关资料推荐

推荐一些相关的资料,解决了我的疑惑,也可能解决你的疑惑。

  1. The magic behind configure, make, make install 编译的过程中你要运行无数次 ./configure && make && make install ,这篇文章解释了这些命令是哪里来的,以及 ./configure 和 Makefile 是从哪里来的;
  2. Libraries: Static or shared?

电影推荐

有些编译很漫长,第三轮 glibc 要将近1小时,第三轮 Gcc(加上 check)需要4h左右。准备些爆米花边看电影边编译吧。

  • 《勇士》 汤姆·哈迪主演的拳击题材的电影;
  • Rudderless 一个比较复杂的话题,音乐题材;
  • 《血钻》 莱昂纳多·迪卡普里奥主演的战争动作片,讲南非黑钻的故事。

最后,如果在构建的过程中遇到问题,可以在这里留言,大家交流学习。
 

/bin /usr/bin 和 /usr/local/bin 的故事

Linux 系统的 $PATH 变量通常会包含 /bin /usr/bin /usr/local/bin 。这三个目录下都有一些 binary 程序,至于有什么区别,网上有很多错误的解释。(就像介绍 HTTP GET 和 POST 有什么区别这个问题一样)。本文试图说明这个问题,基于我的理解和 Linux 文档。(本文里说的 Linux,更准确的说,应该是 Unix系系统)

TL;DR

这些 bin 的位置,仅仅是几个目录而已,并没有本质的区别。哪些命令放在哪里,完全看用户和发行版的喜好。比如,有一些发行版将 /bin 作为 -> /usr/bin 的符号链接。[命令,Ubuntu 放在 /usr/bin 下,OS X 就放在了 /bin 下。

但是通常来说,我们都认为这几个目录这样安排:

  • /bin 放置系统的关键程序,比如 ls cat ,对于“关键”的定义,不同的发行版会有不同的理解;
  • /usr/bin 放置发行版管理的程序,比如 Ubuntu 自带 md5sum ,这个 binary 就会在这个目录下;
  • /usr/local/bin 放置用户自己的程序,比如你编译了一个 gcc,那么 gcc 这个可执行 binary 应该在这个目录下;
  • 除此之外,还有对应的三个目录 /sbin /usr/sbin /usr/local/sbin ,放置系统管理的程序,比如 deluser chroot service ;

需要再次强调,这是一种文件的管理方式而已,你甚至可以把自己的 binary 放到 $HOME/bin 下。还有,OS X 用 homebrew 安装的软件,会放在 `/usr/local/Cellar` 下,然后在 /usr/local/bin 创建一个指向相关 bin 目录的符号链接;但是在 Ubuntu 下,会放到 /usr/bin 下。

更深的理解

(这一段来自知乎的 in nek)另外,需要知道 / /usr /usr/local 这些都是 prefix,你编译一个软件的之后,要执行 ./configure --prefix=/usr/local 然后 make && make install 。那么 /usr/local 就会作为 prefix,库文件就放在 /usr/local/lib 下面,配置文件就放在 /usr/local/etc 下面,可执行文件(binary)就放在 /usr/local/bin 下面。

然后我们看看这些prefix是怎么选择的。如果你编译过FreeBSD一类的系统,你会发现,这些系统的系统库,基础工具和内核是放到一套代码树中的,编译这个代码,内核和核心库,工具是一同完成的,这些都被认为是操作系统的一部分。这些核心文件,就以根目录作为prefix。所以,/是所有操作系统核心程序的prefix。

在这个核心之外增加新的程序,构成一个发行版,这个发行版增加的程序就用/usr作为prefix。

你把发行版安装好了,安装发行版之外应用程序,那些程序通常用/opt, /srv作为prefix。

但如果你自己从源代码开始编译一个应用程序,这些程序是专门向你这个Site编译的,这种情况下,默认的prefix是/usr/local。

一些历史…

可以看到,不同的发行版会有不同的理解。所以就有 Filesystem Hierarchy Standard 想要指定一个文件等级的标准。(其实我认为这个标准没有太大意义,这种规范不能强迫所有的发行版去理解。与其去理解这个,不如去理解你的发行版是怎么思考的,适用和学习你称手的发行版)。

即使现在大多数人认为这三个目录的含义就像本文开头讲的那样,但事实是,这三个目录创建的时候的目的不是这样的。

事实是,Ken Thompson 和 Dennis Ritchie 在 1969 年创建 Unix 的时候,用的是 PDP-11,磁盘是两块 RK05,每块只有 1.5M。

后来系统变得越来越大了,一块磁盘不够用了,需要用到第二块磁盘,于是就 mount 了第二块,叫做 /usr 用来放用户的文件(想象一下,有两块磁盘,一块放系统,一块放用户数据,非常合理)。然后把系统的目录,/bin /sbin lib … 都复制到新磁盘下,在新磁盘读写。

后来他们有了第三块磁盘(啊!!),mount 在了 /home 下,只把用户的文件移动了过去。这样通过不同的磁盘挂载到不同的地方,系统可以利用起3块磁盘了。

当然,他们必须有个规则:“当系统第一次启动的时候,第一块磁盘里面必须有所有需要的程序,来挂在第二块磁盘到 /usr,比如 mount 。如果 mount 放在 /usr/bin/mount 这里,就会遇上先有鸡还是先有蛋的问题。” 非常合理。

/bin 和 /usr/bin 的分裂是人为的,1970 年的这个实现细节一直延续了下来。要怪就怪那些墨守成规,不问为什么的人。

可以说这个分裂是“没有必要的”,如果磁盘空间足够的话。但是后来由于种种原因,这个“没有必要”的假设就被打破了。其中一个原因是,后来引入了共享库(动态链接),/lib 和 /usr/bin 必须 match。之前没有这个问题,因为所有的东西都是静态链接的。

Anyway,自从有了这两个目录,人们便开始赋予它们含义:/ 用来存放上游的文件,/usr 放本地的内容;后来演变成 / 放从 AT&T 官方发行的内容,/usr 放发行版的内容,那时是 IBM AIX 或 Dec Ultrix,/usr/local 放自己本地的内容;再后来人们觉得 /usr/local 放安装的新 package 不够好,那再加一个 /opt ! 将来说不定还有 /opt/local。

后来有一些组织尝试将它们标准化,比如我们前面提到的 Filesystem Hierarchy Standard ,但是他们并没有尝试去理解一开始为什么会这样……


参考资料:

  1. Filesystem Hierarchy Standard
  2. THDP: Linux Filesystem Hierarchy
  3. Understanding the bin, sbin, usr/bin , usr/sbin split
 

你的Linux上有一个超酷的 TCP 代理!

TL;DR 本文只用 Linux 自带的工具实现了一个可以将 TCP 流量打印出来的中间人代理程序(透明的)。脚本来源于这里。本文是对其工作原理的解释。


一般我们想知道一个 TCP 连接收发的内容时,会用 wireshark/tcpdump 这种工具,来把包抓下来分析查看。我开发 IRedis 的时候,就经常有这种需求,需要看看我的客户端对 server 到底发送了什么和接收了什么。用抓包工具不太方便,信息比较杂乱,操作也比较繁琐。在服务器上部署抓包工具的时候,还要给这些工具特殊权限。

其实这种需求可以不抓包的。因为 Redis 这种程序(RESP3协议)是基于 TCP 的,我们可以做一个代理,将发往 redis-server 的流量打印出来(输出到 stdout),然后再发给 redis-server。将 redis-server 的 Response 打印出来,再返回给客户端。相当于是一个中间人。

实现正向代理和反向代理都可以,反向代理不需要客户端支持,只是开一个端口,将所有发往这个端口的流量转发到 redis-server,所以我们这里用反向代理来实现。

在这篇文章中,我们只用 Linux 自带的工具,nc 来实现这个代理。还要用到 named pipe(因为 Linux 的 pipe 只支持单项传递,这里我们需要一个双向的代理),sed(用来对输出稍作格式化),trap (负责在退出的时候清理 named pipe)。

工作原理

我可以用一个最小化的版本解释这个中间人代理的工作原理,然后我们再来处理格式化输出。

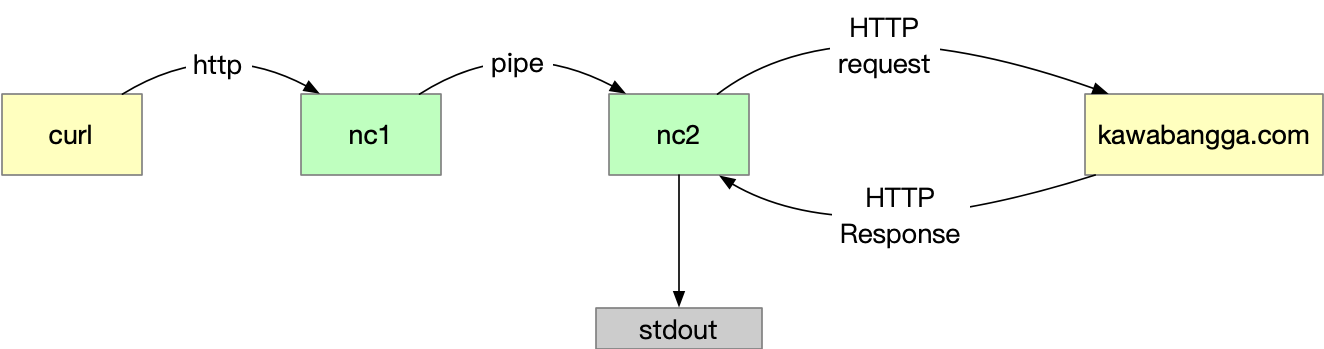
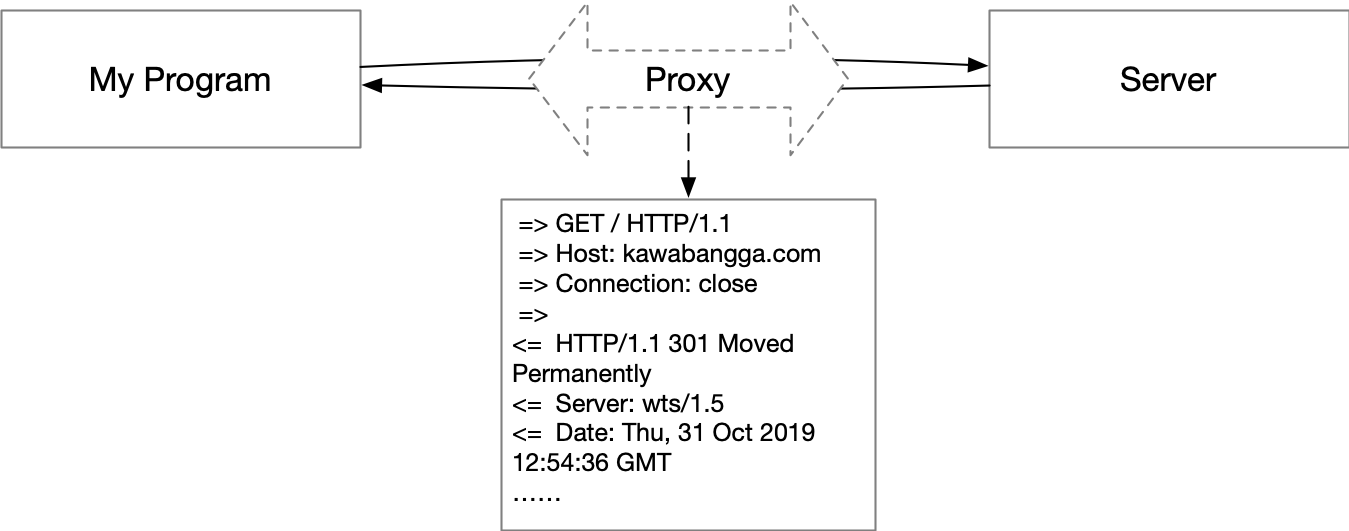
这个中间人代理只需要两个 nc ,一个负责接收客户端那边的输出,将这个输入传给另一个 nc;另一个 nc 接收前一个 nc 的输入,然后传给 Server(比如 redis-server)。Server 传回来的信息也一样,先进入后一个 nc (后面称呼它为 nc2 好了),然后传给前一个 nc (后面叫做 nc1)。在 nc1 -> nc2 和 nc2 -> nc1 的过程中,就可以把传递的东西给打印出来了。

我们先写一个简单的版本:

这一行是监听 8800 端口,把收到的内容通过管道发给 nc2,然后 nc2 将内容发给 kawabangga.com 的 80 端口。其实就是一个 HTTP 代理啦。

用 curl 来试一下:

注意这个 curl 是卡住了,并没有信息返回。

而两个 nc 那一行的输出是:

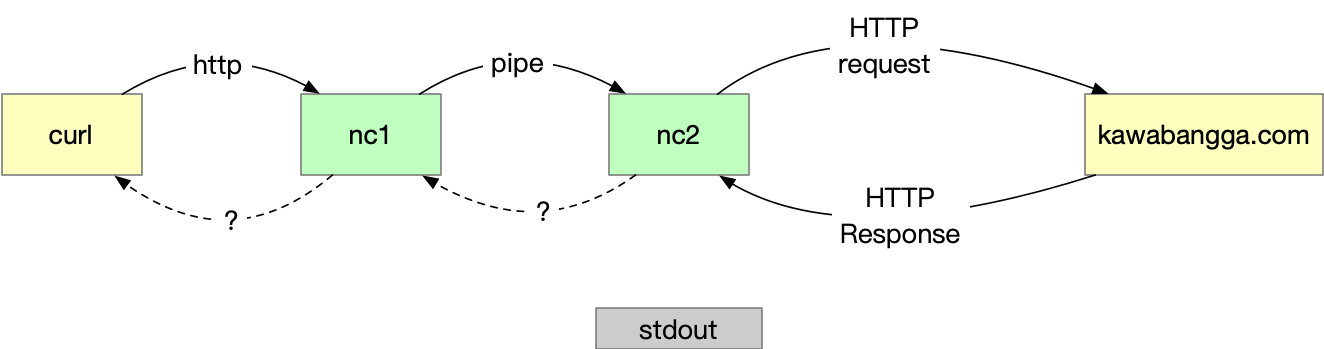
可以看到,第二个 nc 把服务器的返回直接输出到 stdout 了,而并没有返回给 curl。这样的代理是不合格的,因为我们不想夺走本该属于 curl 的 response。

一个优秀的代理应该完整的将服务器的回复还给客户端(curl),像下面这样。至于 stdout 的问题,我们先不管。

Linux 的 pipe 只支持从一边传给另一边,是单向的。那怎么做到后面的进程往前面的进程传呢?答案就是 namedpipe。Named pipe,嗯……顾名思义,就是有名字的管道。在本文中,理解成有了这个名字,我就可以控制重定向的方向,就好了。

我们用这一行,就完全可以实现图2那种传输。即 nc2 通过 named pipe 传给 nc1 ,nc 默认会将自己的 stdin 的内容传回给连接到 nc 的 TCP 另一头。

用 curl 再来试一下:

而 nc 那个命令行没有任何输出。

中间人打印TCP内容

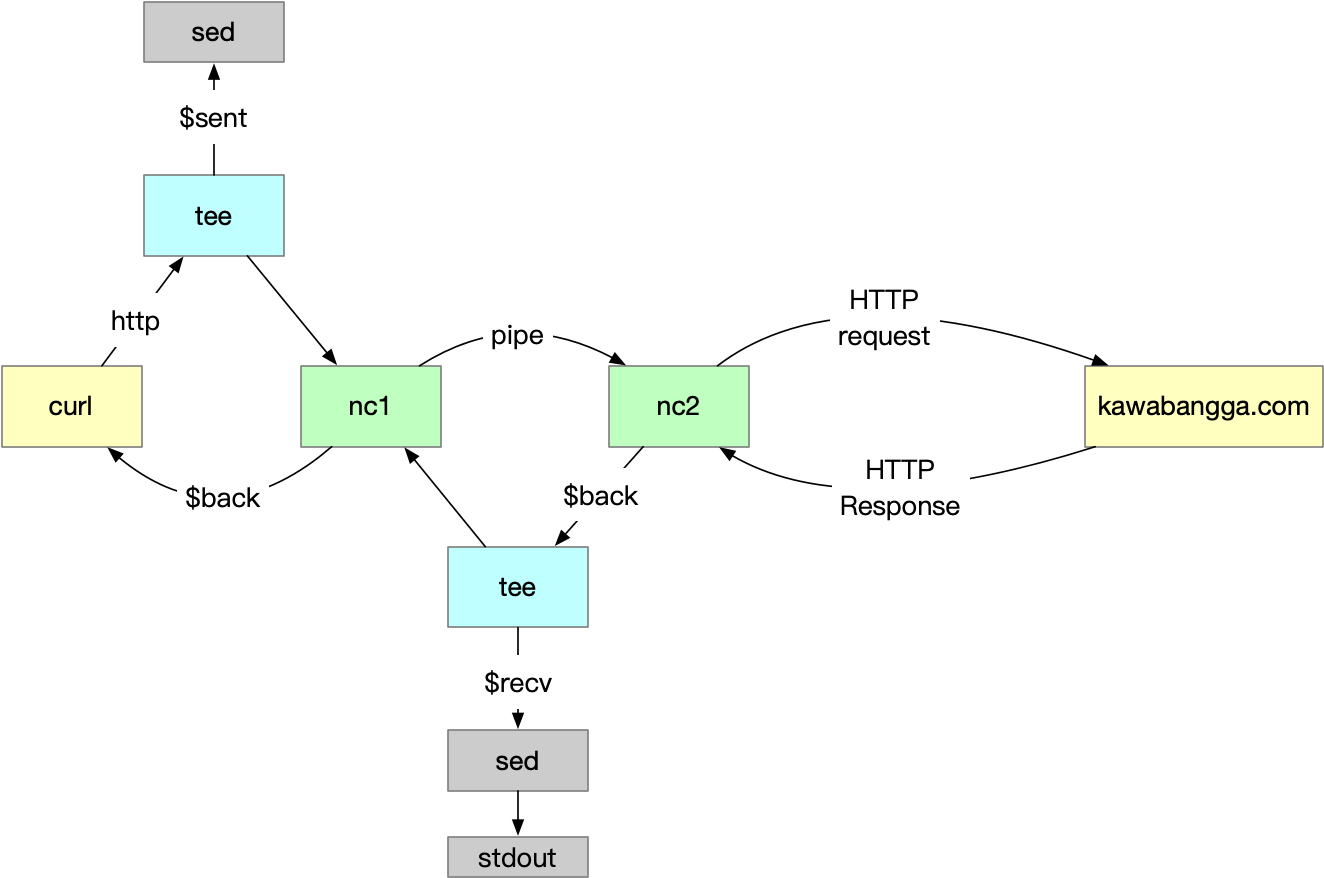
OK,代理已经工作了,接下来要做的是将 TCP 内容打印出来。这里要做的是 nc 在将内容输出到 stdout (即管道)的同时,还要打印出来。

……当然是要用 tee 啦!

这样可以用 tee 将 TCP 流量分别保存到 in.txt 和 out.txt 里面。可以用上面用过的 curl 测试一下。

因为 stdout 会被管道重定向,所以我们这里无法直接输出到屏幕了。那咋办呢?一不做二不休,再用 named pipe 将 tee 写入到 named pipe 中。

curl 之后,用 cat logging 就能看到 TCP 的内容啦。(这里如果不使用 cat 读出来 pipe 的内容,curl 会被 block 住)。

最终的脚本

最后,加点细节。写个脚本自动生成 named pipe,使用 trap 在退出的时候把创建的 named pipe 删掉。用 sed 格式化一下输出,分别加上 => 和 <= 。


代码如下(BSD 的 nc,适用于 OS X):


nc 的 BSD 版本和 GNU 版本不一样。如果你用的不是 Mac,要改下最后一行,加一个 -p. GNU 版本的代码如下:


使用效果如下(还是用 curl 测试):


作为 redis-server 的代理效果:

Pretty cool uh? Now I am going to drink some tea!


Vim LSP 配置

用了好几年的 YouCompleteMe,体验还是不错的,最爽的一点是能基于 Token 补全在当前 buffer 中作补全,任何语言用 Vim 就有一个“基本可用”的体验,即使写 git commit message 的时候也很好用。

但是最近玩一些神奇的东西,YouCompleteMe 如果没有支持这种语言的话,就没办法做到一个比较好的体验了。

对于一种语言,YouCompleteMe 都要去实现这种语言的支持,才能起作用。每增加一种语言,YouCompleteMe 都要增加一种工作量。不光 YouCompleteMe,像 Emacs,VS Code,都要去实现每一个语言的自动补全。这就形成了很大的浪费:每一种编辑器要去自己实现每一种语言。如果有人写了一个新的语言想要其他编辑器支持,需要一个一个实现编辑器的补全工具。

这就形成了一种交叉关系,假如有三个语言,三个编辑器存在,就需要9个补全的实现。

所以 VS Code 就提出了 “Language Server” (简称 LSP)这种先进的概念。这是一种 Client-Server 架构,每个语言实现自己的 Language Server,每个编辑器去实现自己对接 Language Server 的前端。这样一个语言只需要实现一次,就可以支持所有的编辑器。上面那种情况,只要有3个语言的补全实现+3个编辑器自己的 Language Server 实现就可以了。

其实 YouCompleteMe 也支持 LSP 的,但是配置上看起来资料比较少,像是不是支持的特别好,所以我索性放弃 YCM 了,转向了 vim-lsp。

配置 vim-lsp

这里以 Python 为例,介绍一下配置方法。

首先需要安装 Python 的 Language Server。推荐使用 pipx 安装。

然后修改 .vimrc 的配置修改,以下是一个最小化配置:

安装的插件需要4个,下面分别介绍一下这四个是干什么用的。

async.vim

因为补全是支持 Vim 和 Neovim 的,async.vim 封装了两个 Vim Async 相关的接口。

asyncomplete.vim

利用 async.vim 做的补全,相当于一个补全引擎。(到这里是和 lsp 还没有什么事儿,配置的都是补全插件。)

这个补全只是负责补全引擎,具体的补全还是要交给依赖此引擎的实现。比如我们想要对路径进行自动补全,需要先安装这个插件,再安装基于此插件实现的路径补全插件,最后对补全引擎注册这个插件,才能使用。安装路径补全插件和注册的配置如下。

还有很多挺有意思的补全,比如这个 tmux-completion,是基于 tmux 的窗口 buffer 来补全,在 vim 中抄写 tmux 里面的 git hash,URL 啥的挺有帮助。但是我没找到禁用它的方法,导致它会一直弹出来,太烦人了,就没用。

vim-lsp

是一个与 LSP 交互的插件,类似于一个 Vim 的 SDK。

asyncomplete-lsp

将 lsp 中的内容交给 asyncomplete 做补全。


后面的两个配置,一个是设置用 Tab 触发补全(判断补全窗口有没有打开,有打开的话就将tab键映射为补全选择键。

然后注册 Python 的 LSP。每一个 LSP 都需要注册。

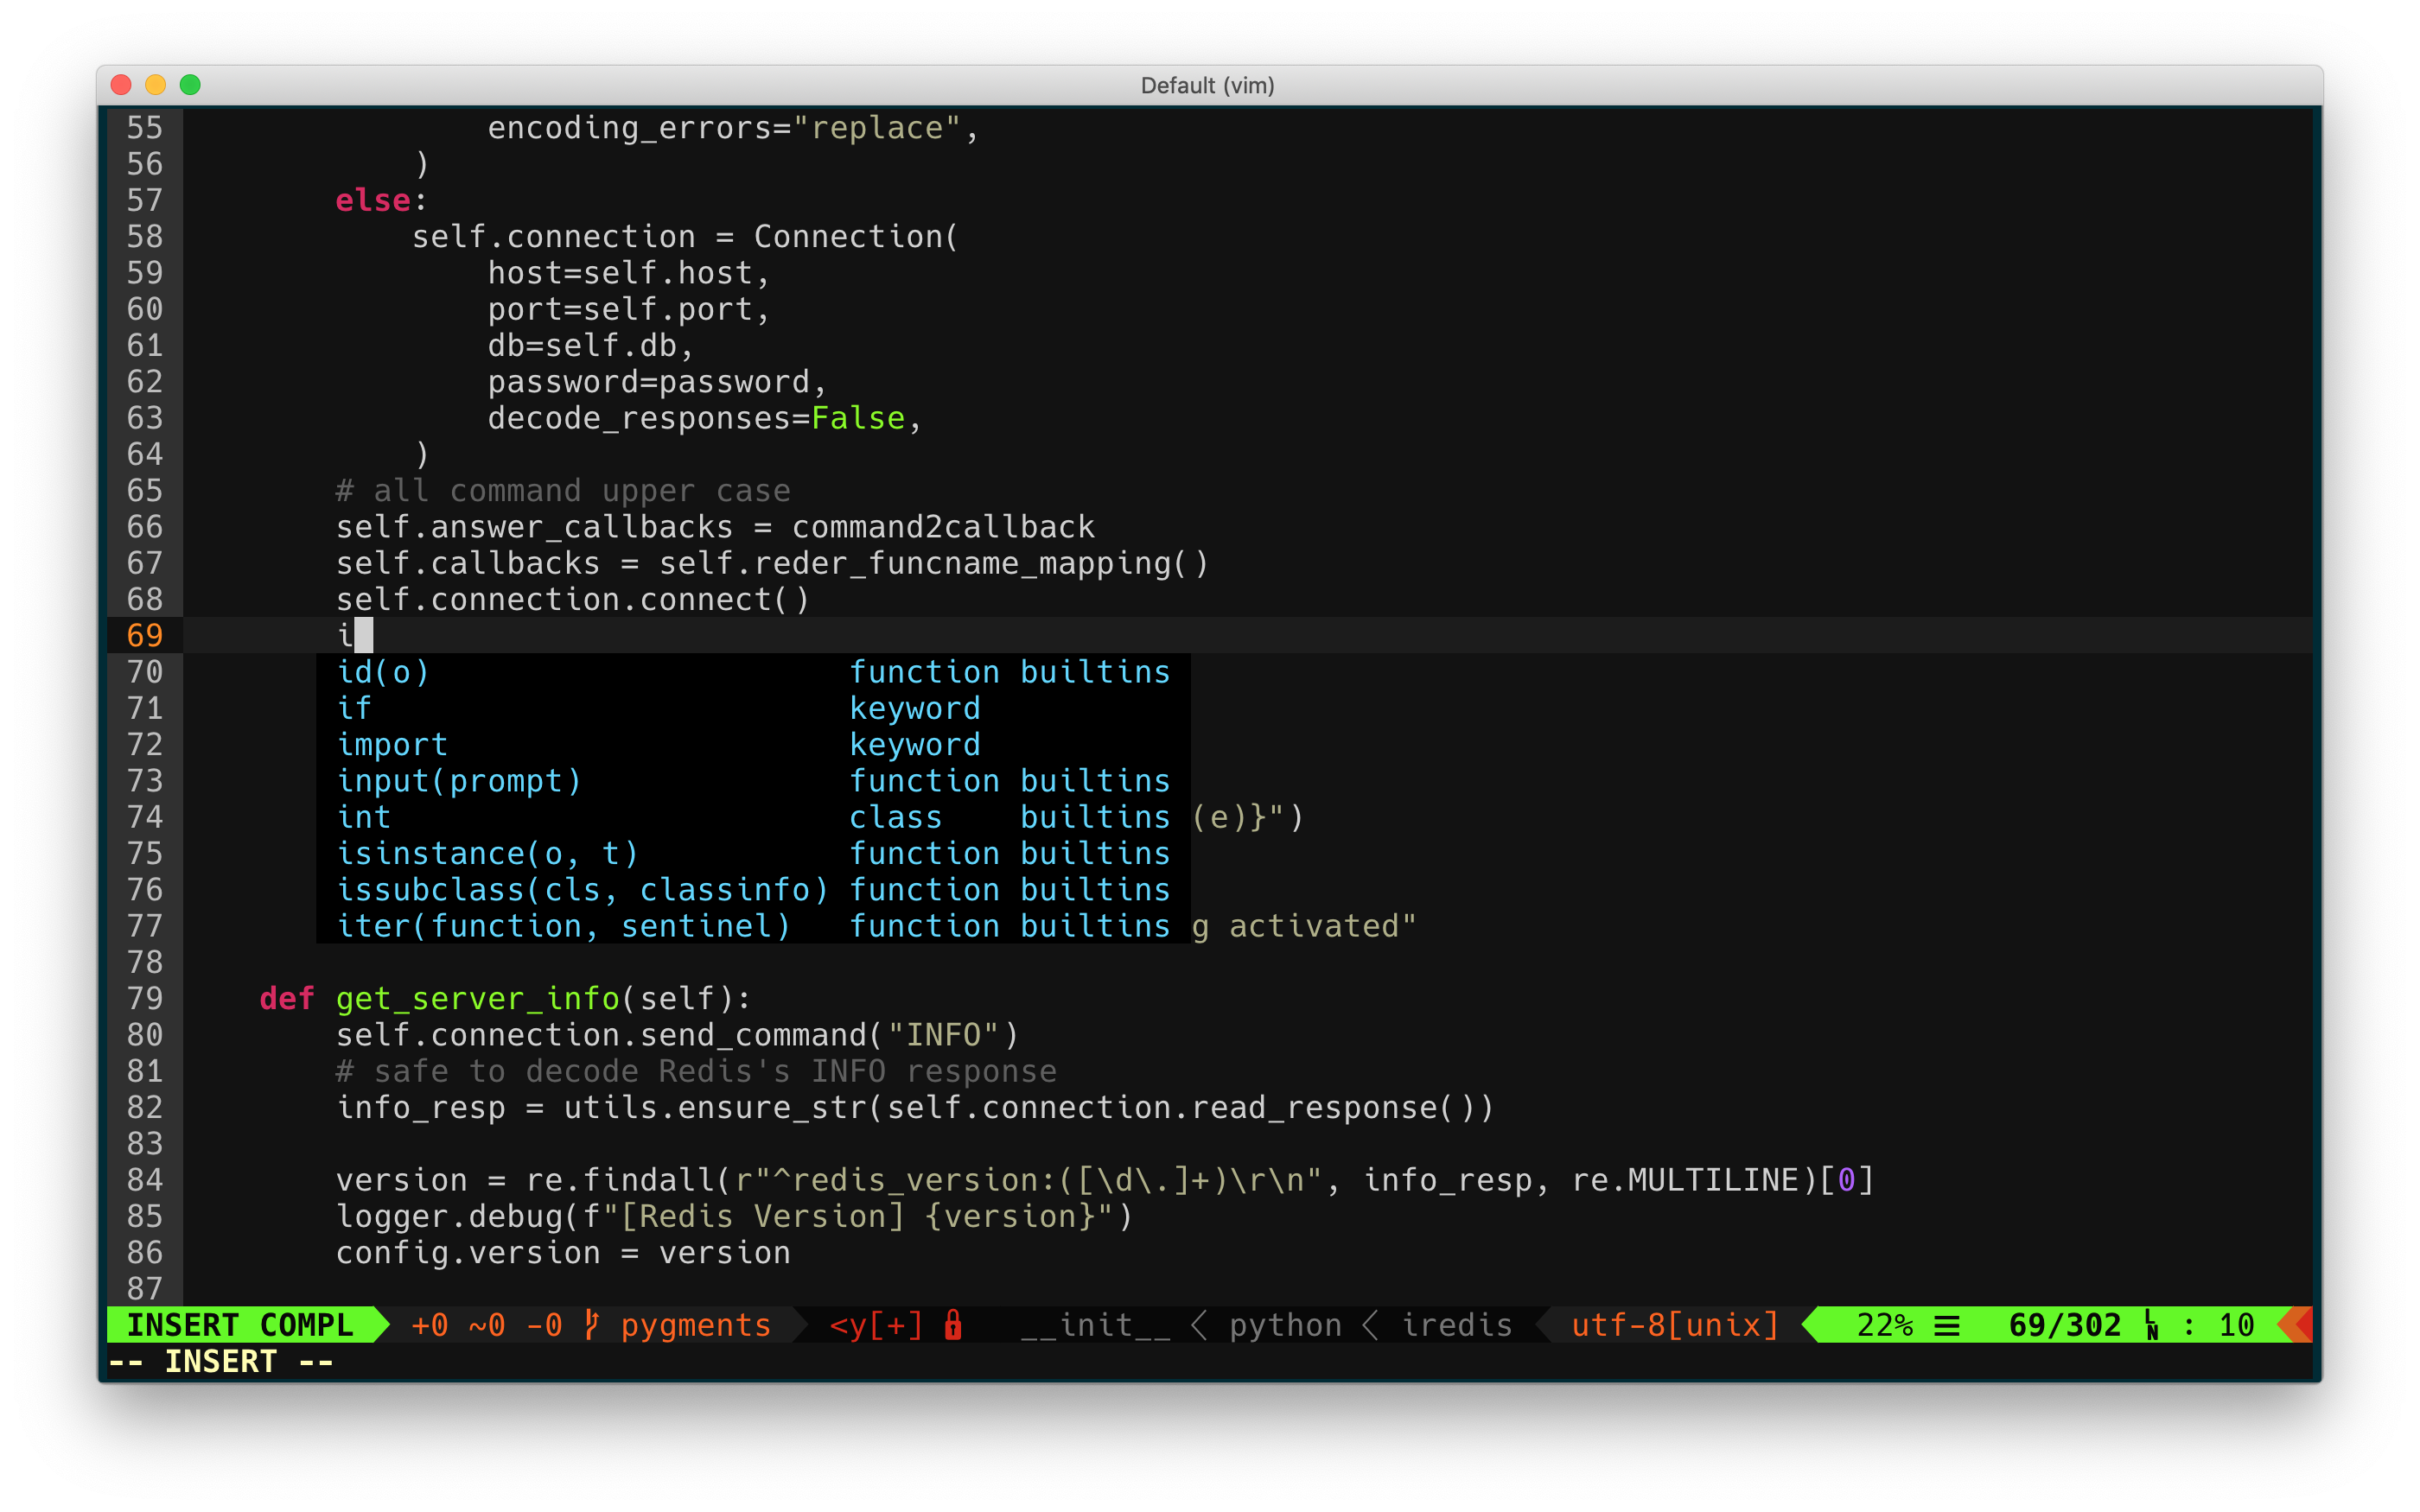
效果如下:

配置好这些插件之后,再配置其他语言的 LSP 就简单多了。分成两步:

  1. 安装该语言的 LSP,这里有一个列表;
  2. 在 Vim 中注册该 LSP;

以 Bash 为例,我们首先按照仓库的介绍,安装该语言的 LSP:

然后在 .vimrc 中用以下配置注册:

换成其他语言的话,只要将 cmd 换成 LSP 的启动命令,然后通过 whitelist 或者 blacklist 设置生效的文件类型就好了。


Snip 的支持

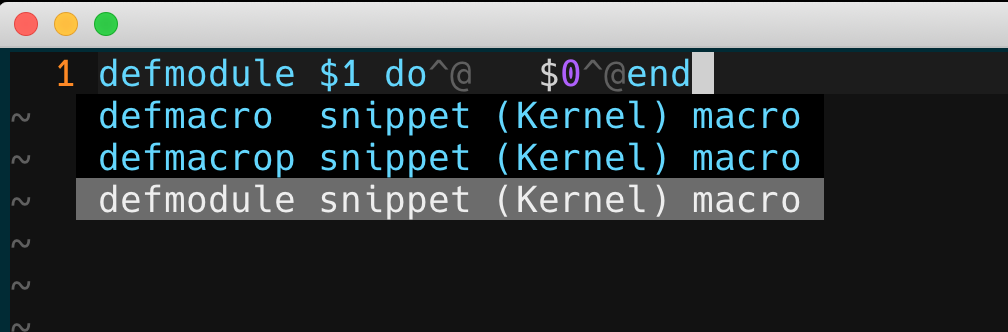
Language Server 支持补全一段代码模板,比如写 Elixir 的时候自动补全 defmodule 。但是 vim-lsp 本身是不支持的,snip 在 vim-lsp 中会补全成这个样子:

将这个片段正确的显示在 vim 中,并且支持跳转,需要通过插件来解析 Language Server 返回的片段。

这里又涉及到 N 多插件。首先你需要一个代码片段引擎,负责在 Vim 中生成片段,在片段中需要填写的字段中进行来回跳转,补全。之前在博客中介绍过 Ultisnips ,这里就以它为例。

除了 SirVer/ultisnips 本身,还要安装两个插件来将 LSP 中的 snip 补全到 vim 中来。总共需要安装的插件如下:

然后有一个小坑需要注意,Snip 必须确认选中才能展开,也就是菜单中将焦点移动到这个 Snip 上去之后,需要按 Ctrl + y 来展开。

但是这个快捷键可以更改,比如我换成了 Ctrl + o


单页应用的登陆验证方式

前端流行的单页应用(SPA),带来了很多体验上的优化,也带来了很多问题。以往我们每点击一次鼠标,页面就会在后台生成一次,很多事情都会很简单。但是到了单页应用,相当于访问页面的时候只请求了页面一次,后面的数据、表单等都是通过 AJAX 的,页面的渲染由前端完成,给后端带来了很多挑战。

比如说登陆验证,传统的页面每次请求都会经过后端判断一下 Cookie 中携带的信息,如果用户没有登陆,就将用户重定向到一个登陆页面。

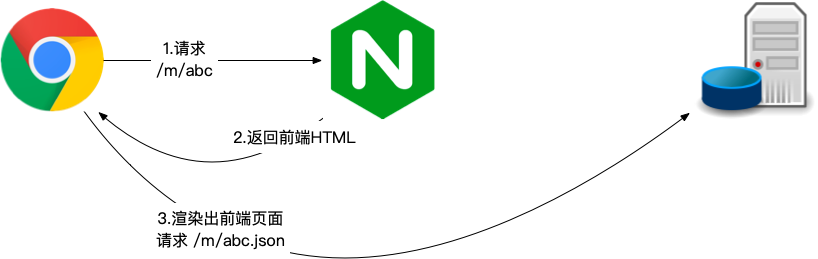
但是单页应用一般是页面先渲染出来,然后通过 API 访问后端,虽然鉴权方式还是通过访问 API 的时候携带 Cookie,但是用户将会先看到页面加载出来,然后访问 API 得到 403,跳转到登陆页面,体验就不太友好了。(应该是页面都渲染不出来,直接跳到登陆)。

今天用了一个方法,Nginx 配合后端的应用,来解决了这个问题。这篇文章来分享一下原理。

Before:

  1. 用户访问页面;
  2. 用户访问 API;
  3. API 返回了 403;
  4. 用户跳转到登陆;

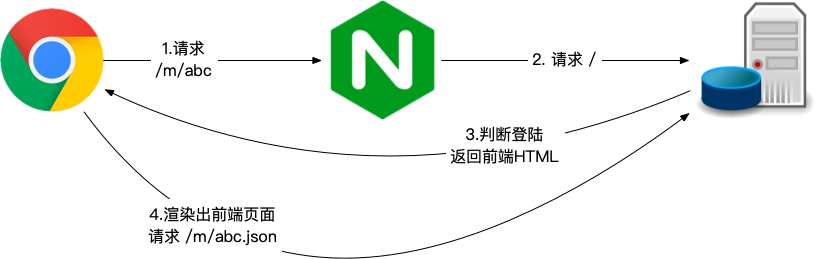
After:

  1. 用户访问页面;
  2. 页面判断用户没有登陆,返回302;
  3. 用户跳转到登陆;

之所以出现这个问题,因为采用了传统的单页应用部署方式,即前后端完全分离。Nginx 负责返回前端页面,应用只是一个 API 服务器。渲染页面这一步应用感知不到。

部署方式

要判断用户是否登录的话,就要让“返回前端HTML”这一步交给应用来做。(假如我们想保持 Nginx 不涉及业务逻辑的话。)有人可能认为这样会很慢,实际上返回HTML这一步是很快的,因为这个 HTML 很小,我们写的前端应用都作为 <link> <script> 等引用外部资源异步加载,而且这些静态资源一般都是有 CDN 的。

真正可能慢的地方是 URL 匹配。我们知道在单页应用中,你访问 /m/foo 和 /m/bar 都是完全相同的一个 HTML,只是前端应用通过 URL 的不同来帮你路由了。但是访问 /api/foo.json 的时候可能真正访问到了服务器。一般来说,什么时候是访问静态页面,什么时候是请求 API,我们是交给 Nginx 配置来处理的,因为 Nginx 是一个专业的 Web 服务器,URL 匹配的效率很高。虽然我没测试过,但是我觉得 Django/Spring 这种 Web 框架,匹配 URL 的速度肯定要比 Nginx 慢很多。

所以这里需要:

  1. 让应用判断用户是否登录,选择是返回 HTML 还是重定向到登录页面;
  2. URL 匹配还是在 Nginx 做,如果是前端页面,那么 Nginx 就去掉 Path,直接 proxy_pass / 就可以了。那么应用这边只需要对 / 这个 Path 来返回一个 HTML;

Nginx 相关的配置如下:

表示正则 match 到 / 开头的话,就用 rewrite 指令去掉 / 后面的内容,将 URL 改写成 / 。然后 break 参数告诉 Nginx 停止处理其他的 rewrite,传给后端的 appserver 。注意这里我们的 rewrite 只是改写了传给应用的 Path,此时 Chrome 浏览器的 Path 还是完整的,所以我们这么做并不影响前端的路由。

后端的应用只要对 / 这个 Path 返回一个 HTML 就好啦。比如说用 Spring 的话,就这么写:

这个配置其实很灵活。如果你要 /a 是一个 app,/b 是另一个 app 的话,只要将 Nginx 配置替换成西面这样:

然后应用只渲染 /a 这个 Path 就好啦。

总结下原理就是:Nginx 负责去掉单页应用的 Path,替换成根目录,然后 App 负责判断用户是否登录,如果登录就返回根目录的 HTML,浏览器渲染出来页面。

登陆跳转问题

这里有一个小小的问题,就是后端应用将用户重定向到登陆的回收,会带上一个用户登陆完成之后回到的URL。比如用户访问的是 /hello/bar,那么我们希望用户登陆完成之后,直接跳转到 /hello/bar 。

但是因为 Nginx 将用户访问的 Path 给去掉了,应用认为用户访问的是 / ,那么用户登陆之后就看到的是首页,这样体验就不太好了。

解决这个问题,一开始我想用 cookie 记录下用户去登陆之前想访问的 URL (也是在传统网页时代,我们经常用的方法)。这样一来就要区分用户什么时候是想访问的 cookie 的 URL(应该重定向),什么时候就是想访问用户输入的 URL (不需要重定向)。还要注意什么时候应该设置 Cookie,什么时候不要设置 Cookie,什么时候清除Cookie。所以这个方案比较复杂。

搜索了一通之后,我发现 Nginx 是可以对代理后面的服务器返回的 Location Header 进行修改的。

比如我们 proxy_pass 到 appserver,appserver 返回了 302,带有 Location: /abc/de 的 Header,Nginx 可以将 Header 修改成 /foo/bar ,再返回给浏览器。

这个功能就是 proxy_redirect 指令。

配置如下:

注意这里的第7行,如果应用返回了 Location Header,那么这里就会将应用返回的重定向目标,修改成第二个参数所表示的重定向目标。其中,$http_host 是用户请求的 URL 里面的 Host,$request_uri 是用户请求的原始的 Path。


这样,我们就有了和传统网页一致的登陆体验了。