编译安装proxychains4

proxychains的作用如名字所示,将一个应用程序的tcp走proxy。可以走多个代理,像链条一样链接起来(chains),支持混合不同的代理。如:

1.编译安装

2.配置文件

vim /etc/proxychains.conf

添加一行:socks5 127.0.0.1 1080(具体取决于你的ss配置)

3.alias

alias p4="proxychains"

4.使用

p4 curl www.google.com

FAQ

1.没有 work?

可能是 OSX 的保护模式的问题,可以按照 调教Mac外接显示器(开启Hdpi) 相同的方式在 OSX 的恢复模式中关闭保护 csrutil disable 。详见issue。

2.出现以下警告?

因为 proxychain command 不是通过 brew 安装的,比如用 proxychains 代理 git 的时候,git 又不是通过 brew 安装的,是系统自带的那个,就会出现这个。

解决方法是将工具替换成用 brew 安装的。
 

散伙

最近因为毕业的事情真是心烦意乱,因为之前交换的问题,有几门课是最近才会出来成绩的,所以就赶不上第一批毕业的了,传言教务处放假早(再次吐槽我校行政部门,我所遇到的行政楼里面的人都是好吃懒做、态度差的,每天一幅谁欠你钱的样子),如果不是第一批毕业生就等到九月份,这对我来说是不可接受的。现在只是知道自己的毕业审核已经通过了,但是教务处印不印毕业证还没确定。

大学四年,在学校学到的东西很有限。要是说有什么收获的话,很可惜,我觉得真没什么收获。如果大二就一直在外面实习,工作,我觉得可能学到的东西会更多。诚然,你也可能说,这样基础差,不懂计算机的原理,然然。但是我认为,在大学修完计算机本科并不意味着就懂了计算机的原理了。在我看来,很多人的大学生涯都是在划水。随便问点东西,不去准备(指的是针对面试和考试的准备)都答不上来。这个学校的教学系统非常糟糕,逼着学生去花大量的时间做无意义的工作,没有意义的作业。花费大量的时间在一些根本不能称之为知识的课程上(指的是毛概这类课程)。很多老师也是混子,相当恶劣,上课基本是在念ppt,布置作业睁一只眼闭一只眼,毕业答辩的时候学生做的什么根本听不懂,问个问题漏洞百出。评分的机制也非常糟糕,绩点一定程度上可以反应学生的学习情况,但是并不准确。影响评分的还有学生和老师的关系,学生找上一届的学生要作业上交,老师的心情等。造成这种情况的原因主要还是老师的懒惰,拿着相同的内容和课件来机械重复地教给一届又一届的学生。

现在想想,自己在大学四年的大部分时间其实都白白浪费掉了。如果能重来,我想早一点去实习,最好是大二就去;多去图书馆看书;多去尝试一些框架,编程语言,多写代码;理解tcp/ip、函数式编程、计算机组成,计算机经典的书都读一下。

过去就过去了吧。在这个学校的收获,主要在非常nice的同学、曾给我指点的老师、图书馆的书。

班里最近一直有聚会,可惜我都没去,不过大多数人都选择在上海(至少毕业这几年是),所以再聚应该不难。

昨天超唯回家了,才意识到这么快就真的散伙了,不会再有宿舍这个地方,一会去大家基本都在了。也没有可以随时一起下楼买奶茶的人了,毕业,上班,这就是孤独的开始吧。

今天我也回去把宿舍剩下的东西彻底搬光了。

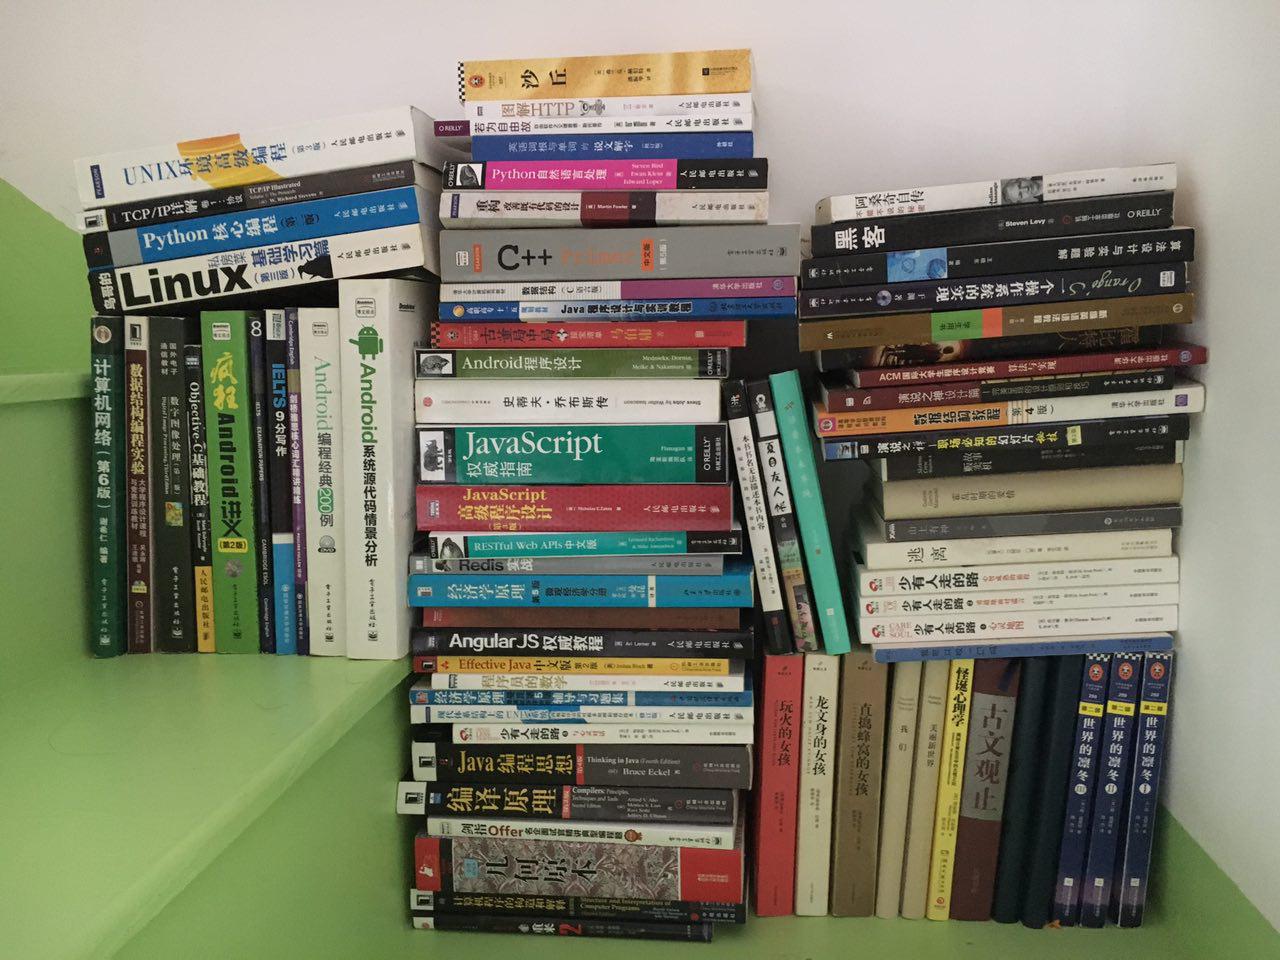
整理了一下书

刚上大学的时候某学长自费引发的小册子

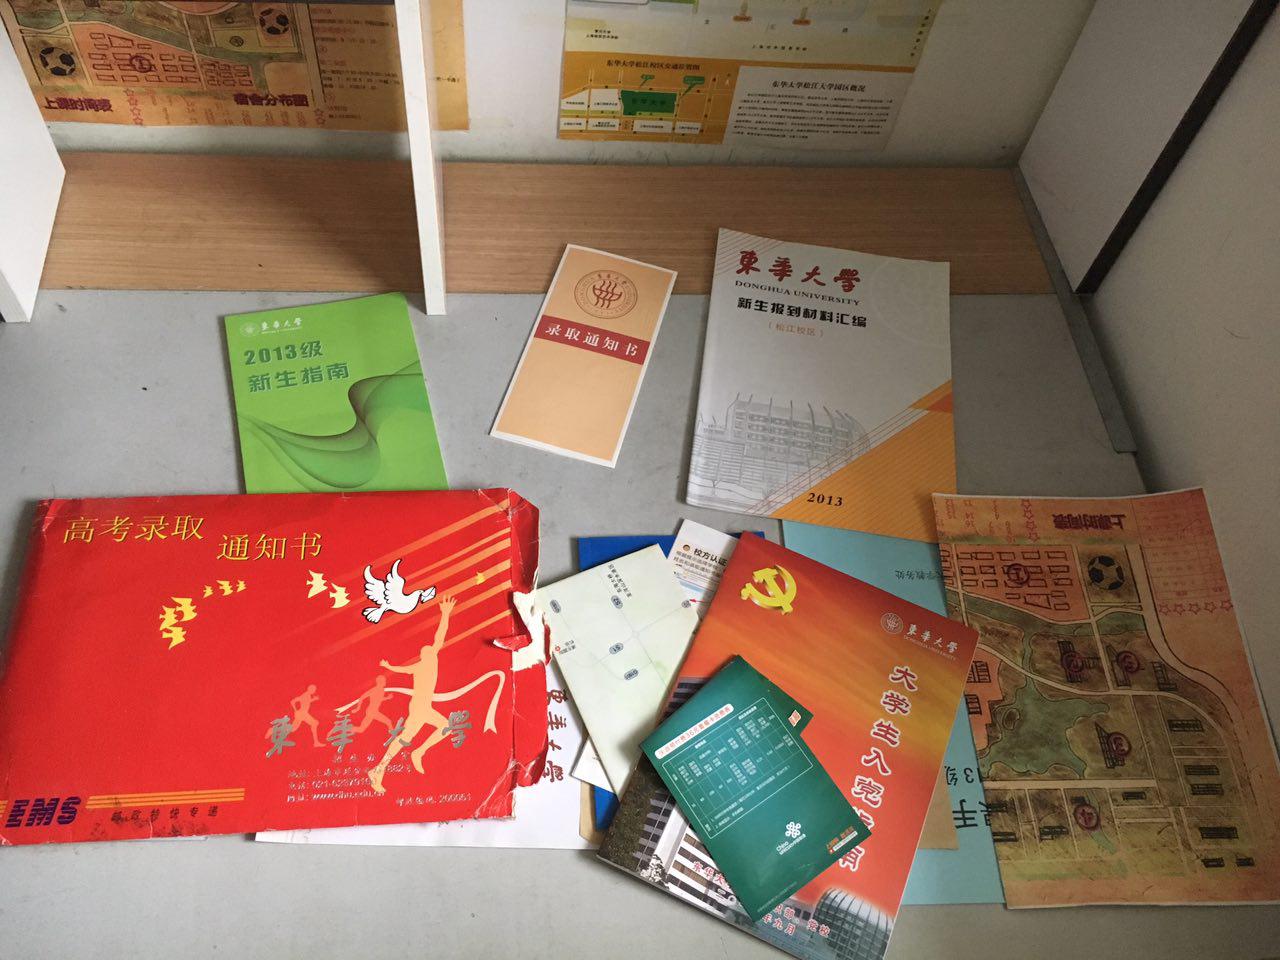
录取通知书,好多同学收拾东西的时候都找出来了

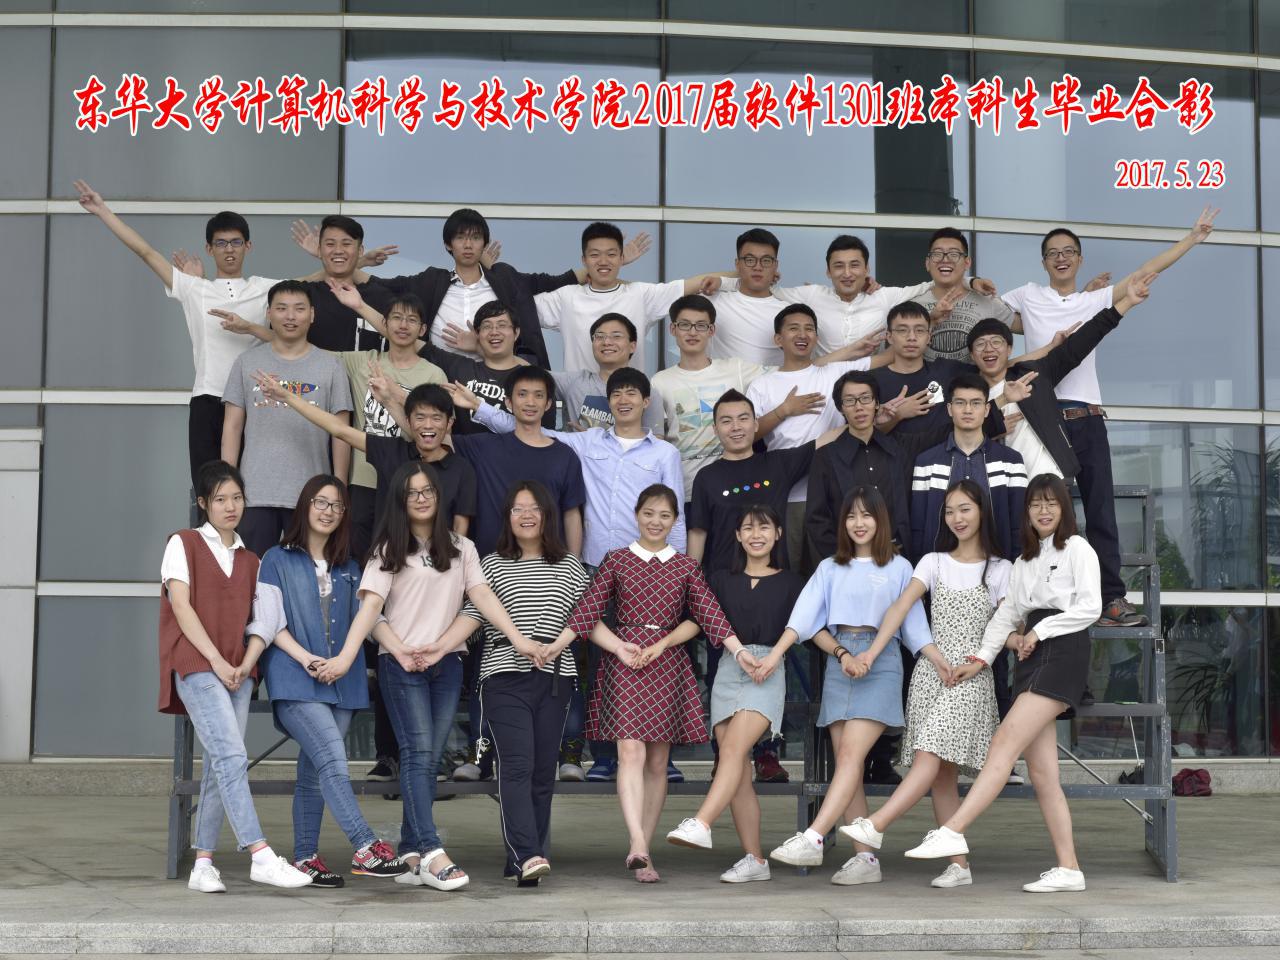
毕业合影


Linux文件打包和压缩命令总结

每次在linux解压文件都要去网上查一次,因为记不住后面跟的参数(原因还是不理解这些参数的意思)。所以总结解压命令。

tar命令

首先,tar是一个打包工具,并不是一个压缩工具,tar的压缩功能是调用了别的工具来实现的。

tar命令的用法是 tar [function] [option] pathname。其中必须选择一个function,相当于是指定tar的任务。function可以用简写首字母,可以与后面的option混用(所以之前我都不知道有个function的存在,以为都是option)。所有的function支持见下表。比如说,如果要创建一个归档文件,就用tar -c,如果是从归档中提取文件,就是tar -x。

FUNCTION LETTERS
Main operation mode:

-A, –catenate, –concatenate
append tar files to an archive

-c, –create
create a new archive

-d, –diff, –compare
find differences between archive and file system

–delete
delete from the archive (not on mag tapes!)

-r, –append
append files to the end of an archive

-t, –list
list the contents of an archive

–test-label
test the archive volume label and exit

-u, –update
only append files newer than copy in archive

-x, –extract, –get
extract files from an archive

然后是options,其中有一个option(-f)是必须的,就是指定使用的归档。而且这个参数后面需要跟一个文件名字,所以一般都把它放在tar的最后一个参数上。例如打包文件的命令就是tar -cf new.tar。其中第一个c是函数名,可以和后面的option组合。文件名的后缀是为了好识别,不加也可以(推荐加,不然你就不知道一个文件是文件还是归档了)。

常用的参数如下:

  • -p或–same-permissions:用原来的文件权限还原文件
  • -v:列出处理过的文件,显示运行过程还是挺好的
  • -j, –bzip2:后缀是.bz2形式的压缩
  • -J, –xz:后缀是xz形式的压缩
  • -z, –gzip:后缀是gz形式的压缩

综上,打包一个文件的命令就是:tar -cvzf file.tar.gz dir,解压文件的命令就是tar -xvf file.tar.gz。

我有一点不理解的是,网上的解压命令基本上都是带-z参数的,即tar -xzvf file.tar.gz,但是我尝试了一下不指定解压器也是能工作的,不知道为什么网上都这么说。到论坛问了一下,原来之前版本的tar是不能自动识别压缩编码的,现在已经可以自动识别了,不需要加zjJ任何参数了。

zent00 :早期版本的 tar 无法自动判断文件所使用的压缩算法,所以需要指定 z 或 j,现代版本的 tar 都可以识别了,所以不需要指定 z j J

gstqc:压缩必须指定压缩格式
g: gzip
j: bz2
J: xz

解压以前需要指定压缩格式,现在新版本不需要,加不加 -a 参数都会自动判断格式

所以对于 gz 格式的解压,在新版 tar 上,以下命令全部等价
tar -zxf
tar zxf
tar -xf
tar xf
tar -axf
tar axf

不过,规范一点更好,写脚本的时候,统一使用 tar -zxf 或者 tar -axf 这些参数,免得出 bug

所以还是用Linux比较晚……会遇到一些奇奇怪怪的问题……

zip文件的压缩和解压

另一种跨平台的压缩格式是.zip。这种格式的文件相关的命令是zip和unzip。通过下面几个例子了解一下,用的时候查man就可以。

  1. 递归压缩 zip -r yasuo.zip abc.txt dir1
  2. 解压 unzip yasuo.zip
  3. 查看压缩文件内的内容,但是不解压 unzip -v large.zip
  4. 验证下载文件的正确性 unzip -t large.zip

参考资料

  1. Linux manual:https://linux.die.net/man/1/tar
  2. http://www.vixual.net/blog/archives/127
  3. http://man.linuxde.net/tar
  4. https://www.cnblogs.com/chinareny2k/archive/2010/01/05/1639468.html
 

博客维护:速度优化,嵌入instagram

我对国内的服务提供商简直是醉了,之前Wordpress因为googleapis域名不能访问的原因,字体加载换成了360的,结果360这坑货说停就停了……后来又听说googleapis这域名在大陆可以访问了,就删掉了插件。今天发现从google加载字体还是慢的要死,无奈,这次谁都不信了,直接来最可靠的,去theme文件夹直接把那条link注释掉了(位置:theme/heatmap-adaptive/inc/theme-tags.php heatmapthemead_head_fonts),网站的速度提升一大块。

另外还发现ga(Google Analytics)加载的也很慢,很无奈,虽然非常喜欢Google的这个访问统计服务,但是毕竟也是在黑名单的,还是关掉吧。GA在我的网站上运行了约半年的时候,除了让我知道搜索引擎喜欢的东西,其实并没有什么卵用。哦对了,还让我知道……我的博客确实是没有什么人来看的……不过多少人来看不重要,认认真真的写,总会有读者的。最近在Python 为什么list不能作为字典的key?这篇文章收到一些很有价值的评论,很开心。

优秀的GA和惨淡的流量

话说这国内的服务和国外的简直就不是一个级别的啊,就拿一个页面访问统计来说,GA比百度统计,什么站长统计不知道高到哪里去。可用性还高。然后在国内,只要看谁不顺眼,block掉就是一句话的事。因为这特殊的政策,多少优秀的服务和工具都不能用啊。

今天本来是想做一个页面,展示最近的tweets,因为我每天都会发很多tweets(从chrome的发推插件),基本上是把tweets当做一个“以后在读”用的,所以这些信息保存在博客上,对自己来说是挺有价值的。而且使用tweets的feed功能,就算我的读者不能科学上网,也可以看到我最近的tweets了。可惜找来找去都没有合适的,最多也就是能作为一个siderbar展示在侧边,但是也难免要从Twitter加载图片。我想要的是展示在页面,找来找去,还是没有。

巧的是,找到一个Instagram的。看起来还蛮好看,于是就挂在博客上了。在页面最上方的入口可以访问。当然图片不是缓存的,所以也需要科学上网才能访问。

相关阅读:

http://www.ruanyifeng.com/blog/2007/01/a_land_we_call_homeland.html


Python数据处理笔记(1)

第一次处理比较大的数据,本以为十个很简单的任务,结果花了两天半才算做完,学到不少经验,记一下吧。

任务是给出一个XML文件(gz格式压缩的是45M,我展开之后是450M,不得不说XML的冗余还是蛮多的),里面有240w条数据(每条数据两个字段),用这些数据去ElasticSearch里面查询两属性,最后将一共四个字段导出csv格式。

最后的代码都放在https://github.com/laixintao/test-yorg/tree/master/company200w这里了,数据文件被ignore了。由于是一次性的任务,代码也就执行一次,所以写的比较随意,还被同事吐槽了……

我的思路是,首先解析XML文件,把数据存放到mongodb里面,然后根据mongo里面的数据一条一条去ES查询,最后将数据导出。

现在看来,决定中间用mongo来存储数据而不是直接用从文件解析出来的数据是无比正确的。这么大的文件不能保证程序一次就跑通,而使用文件就不能按数据查询,不能索引,无结构化,带来不必要的麻烦。数据放到mongo之后,后面的每一部都可以看作是针对mongo中的结构化数据进行的,可以随意添加字段,可以针对性的只修改有问题的数据,可以使用多线程/多进程处理。

我以前一直不是很理解数据库的索引,可能因为接触的数据都不大,也没花心思去理解。这次解析XML插入到mongo的时候,等程序跑了一段时间之后就变得特别慢。同事提醒我针对update的字段建立一条索引。索引执行完之后,我去,速度立马提升了10倍(目测)。后来我看到了索引的好处,每次用到数据库之前都是先进行索引再用,后来导致插入的时候变得很慢。建索引也是个学问,太多太少都不好(这段话会不会暴露我跟SB一样)。另外我发现了一个特经典的视频,1分钟理解btree。看完就知道为什么索引能这么快的提升速度了。

在解析XML的时候遇到一个坑,我用的是pyhton标准库的xml.sax,因为etree好像是将文件一下子读到内存里的,可能不太适合大型XML文件,相比之下xml.sax是从一个标签的开始读到结束,处理一次,在处理下一个。具体的代码可以看这一段https://github.com/laixintao/test-yorg/blob/master/company200w/xml2mongo.py,但是characters方法好像并不是只用一次,从处理的结果来看,遇到一些特殊字符(比如html的&)就给断成几段文字了,后来发现了我又将他们连起来的。

导出就没什么好说的,用csv的标准库非常简单。

另外,现在看来自己写程序的时候急急忙忙,生怕没时间运行,但其实要是多花一个小时去写,说不定执行能少十个小时。找找哪些操作占用的时间多,想办法优化一下。比如去ES查数据,有条查询是可以一次查多条的(比如100),这样就可以有效减少网络请求的次数。

总结

  • 处理数据库中的数据,而不是文件
  • 数据很大的话及时建立索引
  • 减少IO的次数
  • 打印处理的进度,不要太多(打印也占用资源的)
  • 尽量先测试,再运行