虽然刚接触网络的时候,就首先学习了分层的模型,大部分的教材也是会在最开始就讲解网络的分层模型,但是与网络分层相关的实践却很少。
笔者直到工作多年以后,对此的理解才慢慢清晰起来。这一篇就讲一下我对「分层」的理解。这些概念看起来很简单,但是结合实践之后,会有不断有新的理解冒出来,越来越深入。
网络是如何连接的?
我们访问一个网站,本质是发送多个 HTTP 请求,然后收到 HTTP 响应。DNS 先抛开不说,因为它的作用是名字和 IP 的对应,拿到 IP 之后,我们和服务器之间的交互就不需要 DNS 了。假设我们现在已经知道了网站的 IP,那请求是怎么从我们的笔记本电脑发送到网站的呢?
从物理层面,这个数据包要从电脑发送到路由器,路由器发送给运营商,运营商内部经过很多的路由器和交换机,最后到达服务器。整个转发链路可以看作是经过了很多次设备两两之间进行转发,每一次包被转发都发生在两个设备之间(广播也可以看作是很多次两个设备之间的转发)。所以这个问题可以聚焦于每两个设备之间转发的时候,对数据包做了哪些处理。

这个图做了简化,只保留了每一层中最重要的地址信息。
二层做转发的时候,比如笔记本发送给路由器,会把 SRC MAC 地址设置为自己的 MAC 地址,DST MAC 地址设置为路由器的 MAC 地址。
它完全不看三层和三层以上的内容。所以数据包对它来说就像是这个样子,IP 地址等三层内容变成了它的数据:

电脑转给路由器,设置 MAC 地址看起来很没必要?是的,这种相当于点对点的网络,没有地址也不会发错的。也确实存在一些其他的二层技术,比如 Frame Relay,二层的包头就没有 MAC 地址(但是有类似 MAC 地址作用的东西)。
但是下面这个结构,MAC 地址就很有用了。比如电脑 1 要发送给电脑 2 内容,DST MAC 地址写 MAC 2,然后交给交换机,交换机就会转发给电脑2。如果没有 MAC 的话,交换机收到这个包,就不知道应该发给 2 还是 3 了。
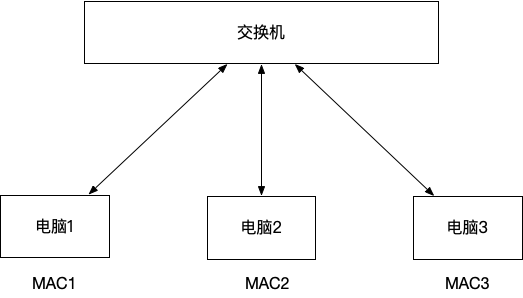
如果有了 MAC 地址,交换机就可以把这个包从 MAC 地址对应的端口转发出去。
如今的大部分交换机都是非常「智能」的设备,可以通过查询 MAC 地址查找对应的端口进行转发。四十年前的设备不这么智能——它从一个端口收到包,就直接转发给其他所有的端口,就是 Hub(集线器)。所有的主机都会收到这个包,但是会检查 MAC 地址是否属于自己,如果不是,就丢弃。Ethernet 本身的设计就是将包转发到所有的端口,按广播的设计来的,所以它有冲突检测等设计,如今已经很少用到了。
三层转发同理,它只关心三层的内容,最重要的是 IP 地址。检查目标 IP,然后根据自己的路由表,在多个接口(路由器一般有多个接口,连接不同的网络,家用路由器可以理解为有两个接口,一个连接家里的内网,一个连接 ISP 那边的网络)选择其中的一个,然后通过这个接口将数据发送出去。路由表可以理解成是三层设备的一个转发数据库,是它最重要的依据,它的功能就是给定一个 目标 IP,可以从中查询出一个物理出口,然后就可以使用这个物理出口转发出去。
这个时候,二层网络就成了它的载体:二层用什么技术不重要,只要能给三层把封装好的三层包发到对面就可以,Ethernet 可以,Wi-Fi 可以,Frame Relay 也可以。如果是 Ethernet 的话,就把三层包封装到一个二层里面,即在外面贴上 DST MAC 地址是对面的设备,SRC MAC 是自己的 MAC,最后用物理层发送。
所有上层协议都可以依赖 IP 协议发送自己的数据,TCP, UDP, ICMP 等等,都是将 IP 作为载体。
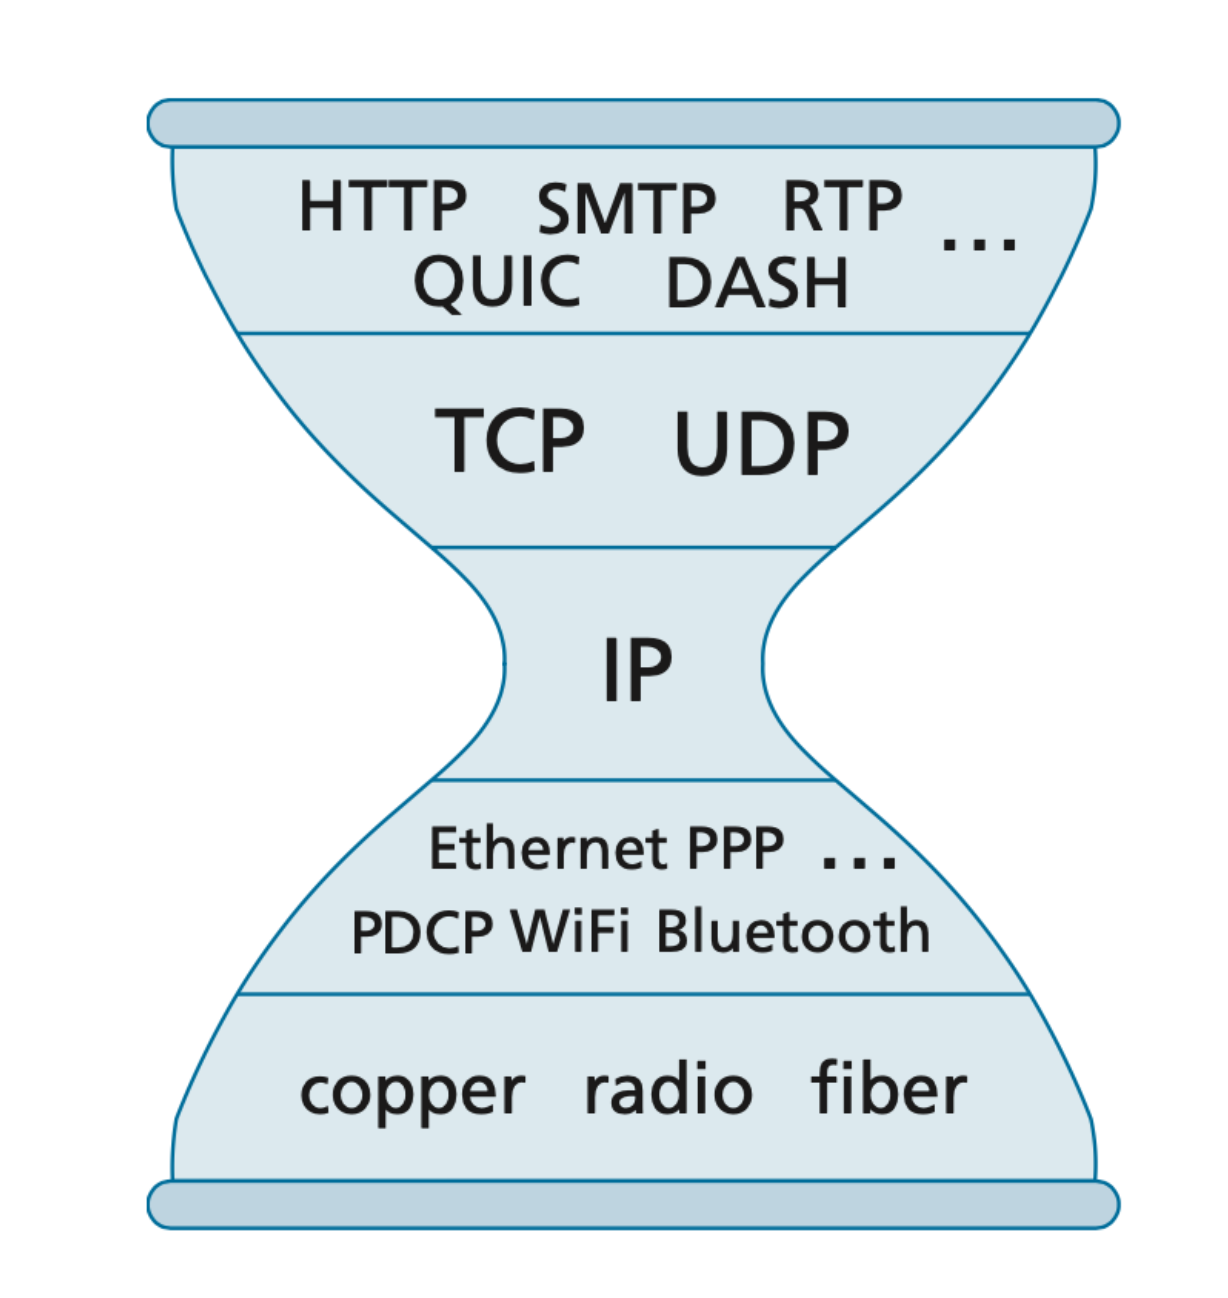
通过互联网我们可以访问世界各地的网站(从网络的角度说,就是服务器,设备),就需要我们的电脑和世界上所有的服务器之间,都存在两两连接的线路,这些线路通常都是物理线路,海底光缆,ATM 线路,双绞线,铜线等等。无线技术一般只会用在接入层,因为它信噪比较低,转发设备之间很少用无线技术,一般都是物理线路连接的。所以网络上有人吵架的时候说「我要顺着网线爬过去掐死你」,假设他真的能够顺着网线爬,那么他确实能够从家里的网线爬到世界的任何地方。
所有的设备之间能够互相通讯,这就要求这些设备之间都运行了某种一样的协议,才能懂彼此的语言。这个协议就是 IP。IP 的上层有很多协议,下层也可以依赖各种协议,但是中间必须是 IP。每一个网络的自治域内可能使用非 IP 协议(但是我好像没听说过),但是自治域之间,都是用 IP 交换信息的,交换 IP 路由信息的协议都是用 BGP。就像一个沙漏一样。
不同层的设备
网络中所有两个设备之间的转发都要经过物理层。物理层能做的事情相对较少。「集线器」就是物理层的设备,说它是物理层是因为二层及以上的数据都是它的内容,它连二层的内容也不看。从一个口收到数据,无论是什么,都直接复制到其他的口发出去。像是一个「端口复读机」。
二层设备主要是按照 MAC 地址转发,它不修改包的内容。不过上面的例子不知读者有没有发现一个问题——交换机怎么知道哪一个接口对应 MAC2 呢?如何将收到的包发送出去?其实很简单,如果它不知道,就把这个包发送给所有的接口。和「集线器」不同的是,交换机可能一开始不知道 MAC 和端口的对应,但是它可以学习。学习主要通过收到的包的来源 MAC 地址,比如这个包是从接口 1 收到的,而且包里面有一个 SRC MAC 是 MAC1,那二层设备就记住了,下次发给 MAC1 的时候,我就直接发送给接口 1,不用发给所有人了。这就叫「MAC 地址学习」,学习到的内容叫做 MAC 地址表,存储在内存中。
三层设备就是按照 IP 转发了。三层设备的负担更重一些,因为无法像二层那样简单地从要转发的包里面「学习」路由信息。因为发送者也不知道怎么转发到终点 IP 呀,人家指望着你呢,已经把包交给到你的手上了。三层设备根据自己的路由表转发,路由表可以通过静态配置。比如配置成往 xx 这个网段发送的话,就走接口1,如果往 yy 那个网段发送的话,就走接口2,如果找不到的话,就走接口3,类似这种。但是机房内设备众多,不可能一一手动配置,一般都是动态生成的。即,所有的路由器都知道自己的直连网络,然后在路由器之间交换彼此的信息,这样,大家彼此依靠,共同描绘一个转发地图。具体的路由协议内容非常复杂,就不展开了。总之,三层设备之间在交换两种信息:一种是路由信息,这部分我们也叫「控制面」;另一种就是实际要转发的数据了,我们叫「数据面」。
注意这一段的描述中,我用「二层设备」和「三层设备」来描述,而不是「交换机」和「路由器」,因为现代化的网络中,二层设备和三层设备的界线已经很模糊了,很多交换机都可以做三层转发。比如我们常说的「家用路由器」,它其实是一个 交换机+路由器+NAT + 防火墙。路由器听起来也比交换机高级,其实也不是,机房中有很多交换机是高规格的,比路由器要贵的多,能力也比路由器要猛,几百个口都能达到线速。
网络协议与网络分层
上面的问题,还剩下最后一块拼图:电脑知道要三层怎么封装,加上 IP 就行了,然后得封装好二层才能发出去。路由器的 IP 是手动设置好(或者通过 DHCP 协议得到)的,但是路由器的 MAC (DST MAC) 怎么写呢?
你要在一个陌生的班级的教室里要找李小明,怎么找?肯定是大喊一声「谁叫李小明呀?」
同理,当发送者不知道一个 IP 对应的 MAC 地址的时候,就发给网络内的所有人:「如果有人是这个IP,请回复给我,我的 MAC 是 MAC1」。于是路由器就回复给 MAC1「是我是我」,回复的包 SRC MAC 也设置为自己的 MAC。
所以说 ARP 是几层协议呢?大部分资料说是二层,也有的说二层和三层之间。
我觉得这种讨论没有意义。因为我们实际上在讨论两个东西而且试图将两个概念融合在一起。即:
- 协议工作在几层(基于几层实现)?
- 协议为几层提供服务?
如果分开讨论,就清楚很多了。ARP 基于二层(意味着只用到了二层的功能,不需要三层的东西就可以工作)实现,为三层提供服务,帮助找到 IP 对应的 MAC 地址。
我们可以给很多有类似争议的协议定义:
- TLS 基于四层实现,为应用层提供服务;
- TCP 基于三层实现,为应用层提供服务;
- ICMP 工作在三层,为三层提供服务;
- EIGRP 和 OSPF 基于 IP 协议,为三层提供服务;
- BGP 基于四层实现,为三层提供服务(是不是很神奇?因为 BGP 通过 TCP 交换路由信息,为三层提供转发路由);
为什么要分层?
我的理解是:为了让每一个协议可以处理部分的问题,不同的协议之间可以互相工作。比如 IP 协议只要一个二层帮他转发,任何二层协议都可以,这样,在 Wi-Fi 大普及,2G 升级 3G 升级 4G 等等的时候,我们都可以继续用 IP 协议,不需要跟着升级换代。就像公司划分了不同的部门,每一个部门负责一部分事情,只要将事情做好,部门内部做事的方式与其他的部门无关。
每一个协议都给出了自己的承诺:比如三层协议,它承诺尽可能保证包到达目的地址;四层向应用层保证,用我传输的数据一定不会丢包,一定不会不完整,一定不会乱序,放心好了。所以我们在做应用层编程的时候,从来不需要关心(数据层面的)乱序,丢包等问题。
基于下层协议的承诺来工作,节省了很多力气。有点类似我们编程的时候,不是从头开始写字符串处理,而是用各种库一样。
理解协议
作为用户,我们在使用这些协议的时候,要知道这些协议提供的功能是什么,要求是什么。有点像用三方库之前要阅读文档一样。
这样很多问题其实也就不是问题了。比如「粘包」问题,是一个被人诟病的面试题。它是问「如果使用 TCP 发送多个包,这些包粘在一起无法分开怎么办?」这么问出来就显得提问者不懂 TCP,因为 TCP 的设计就是帮助用户发送一个字节流,它本身就没有「包」这个概念,所有的数据就是要「粘」在一起发送的。这并不能说是一个问题,而是 TCP 本身的特性。如果你使用 TCP 协议,你就要在这之上设计自己的协议,把自己的协议设计成可以让 TCP 使用「流」的方式传送。比如,HTTP 协议是使用 \r\n\r\n 来分割来 Header 和 Body,然后通过读 Header 中 Content-length 的长度来判断 Body 要读到那里;Redis 协议大致是先用一个数字表示内容的长度,读完了的话,再读就是下一个请求了。
再举个例子,就是对 HTTP 协议的误解。作为用户(甚至是程序开发者),我们对 HTTP 的感受可能是:GET 只需要输入一个 URL,Post 需要输入 URL 和 body,URL 在浏览器的地址栏可以看到,但是 Body 内容看不到,所以有人甚至会认为 Post 方法比 GET 更安全。但其实,如果抓包就会发现,GET 和 POST 两个 HTTP method 发送了相同的数据结构内容,GET 和 Post 就是一个字段的区别。所以面试官问:GET 和 POST 有什么区别吗?我觉得从协议结构上除了一个 method 字段之外没有区别:
- GET 也可以发送 Body;
- POST 也可以传输 url params;
- POST 不会比 GET 更安全,POST 的 body 经过抓包也是一览无余;
网络的分层对问题排查的意义
工作中,在排查问题的时候,网络分层也至关重要。
从上面的描述,我们可以得出结论:如果某一层出现问题,这一层上面的所有协议都会有问题。因为上层协议是基于下层来实现的。在排查问题的时候,比如我们连不上数据库,首先使用 nc -v 10.0.0.1 3306 来确认问题,如果连不上说明 TCP 层有问题,然后去 ping 10.0.0.1,如果能通,说明三层没有问题,这就意味着三层及以下不需要排查了,像什么 ARP,路由信息,都不用查了——三层能通四层不通,问题必定出在四层(可能是防火墙 block 了端口)。相反,如果 ping 不通,就需要继续排查下层协议的问题,有没有可能是 ARP 的问题,等等。以此类推,如果在 nc -v 10.0.0.1 3306 这一步发现可以连通,那么说明四层及以下没有问题,就往上看就好了,是不是数据库程序卡住了?
在描述问题的时候,分层模型也能让我们更好地与同事交流。我经常看到有人这么问:「请检查下数据库有没有问题」,问题是,DBA 可能无法登陆你的机器,无法使用你的环境做测试,经过一些检查,他只能告诉你「没问题」。但是问题是有的,可能不是数据库的问题,于是就找更多的人来帮忙,最后大家在群里面面相觑,问题还是在那里。假设用户理解了网络的分层呢?他可能这么提问:「我们连接这个 IP 不通 10.0.0.1 ,端口是 3306,但是可以 ping 通这个 IP」,DBA 马上就可以开始定位问题了。
但是实际上在抓包和分析的时候,没有人会事先告诉你这是第几层的问题。解决实际的问题不是考试,所以我们必须理解每一层的职责是什么,才能根据具体的现象去判断应该在哪一层来寻求线索。
参考资料
==抓包破案录==
通过真实故障和抓包文件,学习网络分析与故障排查。
这篇文章是抓包破案录系列文章(之前叫做《计算机网络实用技术》,后来改名了)中的一篇,这个系列正在连载中,我计划用这个系列的文章来分享一些网络抓包分析的实用技术。这些文章都是总结了我的工作经历中遇到的问题,经过精心构造和编写,每个文件附带抓包文件,通过实战来学习网络抓包与分析。
如果本文对您有帮助,欢迎扫博客右侧二维码打赏支持,正是订阅者的支持,让我公开写这个系列成为可能,感谢!
如果您正在阅读的是题目类的文章,这个目录内容正好用来隔离其他读者的评论。读完题目可以稍作暂停,进行思考,继续向下滑动,可能会被其他的读者剧透答案。
- 序章
- 抓包技术以及技巧
- 理解网络的分层模型
- 数据是如何路由的
- 网络问题排查的思路和技巧
- 不可以用路由器?(答案和解析)
- 网工闯了什么祸?(答案和解析,阅读加餐!)
- BPG 连接建立失败问题 (答案和解析)
- 重新认识 TCP 的握手和挥手(答案和解析)
- 3.5 秒初始延迟问题 (答案和解析)
- 网络断断续续…… (答案和解析)
- 延迟增加了多少?(答案和解析)
- 压测的时候 QPS 为什么上不去?(答案和解析)
- TCP 下载速度为什么这么慢?(答案和解析)
- 请求为什么超时了?(答案和解析)
- 0.01% 的概率超时问题 (答案和解析)
- 后记:学习网络的一点经验分享
与本博客的其他页面不同,本页面使用 署名-非商业性使用-禁止演绎 4.0 国际 协议。